
21 Millionen Songs als Datenfutter: Wie eine Suchmaske die Abrechnung der Musikbranche mit KI erzwingt
Aktualisiert:
Ende Juni 2026 reichte ein einfacher Screenshot, um die Musikwelt in Aufruhr zu versetzen: R&B-Superstar SZA postete auf Instagram das Ergebnis einer Datenbanksuchabfrage: „Habe gerade nachgesehen. Eine KI wurde mit 238 meiner Songs trainiert. Ich wette, manche davon waren nicht einmal veröffentlicht.“ Gefolgt von einer unmissverständlichen Ansage: Wer als Musiker dieses System gutheiße, sei für sie schlicht untragbar (Rolling Stone).
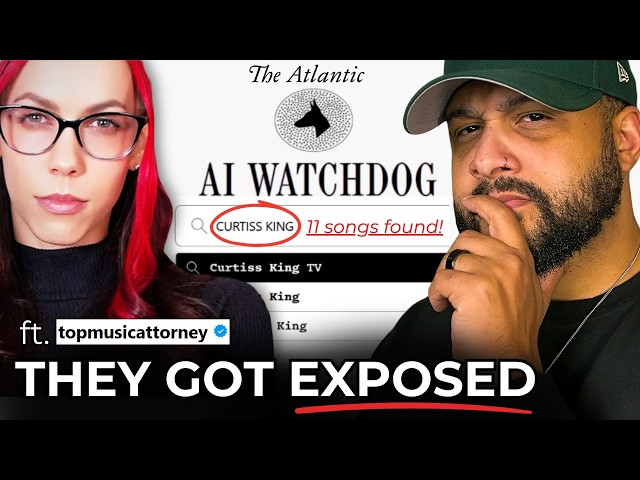
Möglich machte diesen Schnellcheck das Rechercheprojekt „AI Watchdog“ von Alex Reisner beim US-Magazin The Atlantic. Nachdem die Redaktion zuvor schon Datensätze zu Büchern, wissenschaftlichen Arbeiten und Videos durchleuchtet hatte, knöpfte sie sich im Juni die Musikbranche vor: Sie sammelte die in Entwicklerkreisen zirkulierenden Audio-Trainingsdatensätze und stellte eine öffentlich durchsuchbare Datenbank ins Netz. Was folgte, glich einer weltweiten Schockwelle: Von Branchenverbänden über Megastars bis hin zu völlig unbekannten Bedroom-Producern machten sich Kreative auf die Spurensuche. Die Datenbank umfasst die Werke von mehr als 250.000 Musikschaffenden. Sängerin Kehlani spürte prompt 179 ihrer Songs auf (Rolling Stone).
Warum schlägt ein simples Suchfeld derart hohe Wellen? Weil es mit einem Klick das greifbar macht, was lange Zeit ein diffuser Verdacht war: Das eigene Lebenswerk dient längst als ungefragtes Rohmaterial für KI-Modelle – abgesaugt, verarbeitet und kommerzialisiert, ohne dass die Urheber auch nur davon wussten.
21 Millionen Tracks auf dem Servierteller: Was in den Trainingspaketen steckt
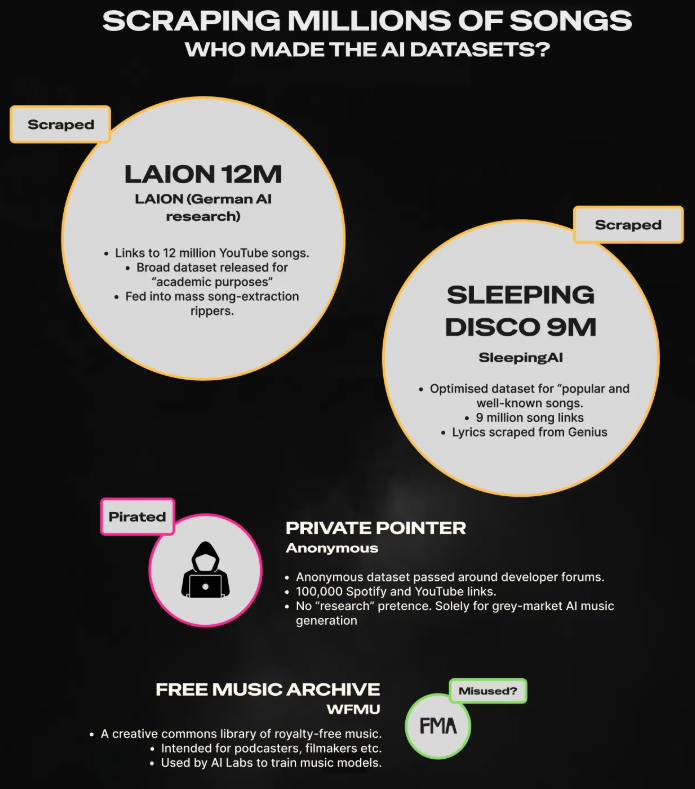
The Atlantic rief das Projekt AI Watchdog 2025 ins Leben, um die Herkunft der Daten aufzudecken, mit denen generative KI-Systeme gefüttert werden. Wie aus den Recherchen des Magazins hervorgeht, basierte die Veröffentlichung auf vier zentralen Musik-Datensätzen: zwei regelrechten Datenmonstern namens LAION-DISCO-12M (12 Millionen Titel) und Sleeping-DISCO-9M (9 Millionen Titel) sowie zwei kleineren Archiven mit jeweils über 100.000 Aufnahmen (Spotify Tracks Dataset und Free Music Archive Dataset). Zusammengenommen ergibt das gigantische 21 Millionen Audiotracks.
Besonders brisant ist das größte Paket: LAION-DISCO-12M wurde im November 2024 vom Hamburger Verein LAION veröffentlicht. Es enthält über 12 Millionen von YouTube gecrawlte Titel mitsamt Metadaten – offiziell zur „Unterstützung der Grundlagenforschung in Machine Learning, Music Information Retrieval und Audioanalyse“. Derselbe Verein hatte zuvor bereits den Bilddatensatz hinter Stable Diffusion geliefert (Rolling Stone).
Auf dem Papier dient LAION-DISCO-12M ausschließlich nicht-kommerziellen Forschungszwecken. Doch in der Praxis der Open-Source-Szene verpuffen solche Schranken schnell: Einmal im Netz, lässt sich die Weiterverwendung kaum kontrollieren. Noch unverblümter geht Sleeping-DISCO-9M vor: Die Entwickler nutzten Tools wie cloudscraper, um Schutzmechanismen von Cloudflare zu umgehen, und verknüpften YouTube-Audio direkt mit Texten von Genius – ein maßgeschneidertes Vor-Trainingspaket für generative Musik-KIs.
Beim Spotify Tracks Dataset wiederum ist die Herkunft völlig undurchsichtig: Ein anonymer Entwickler lud den Datensatz auf Hugging Face hoch; Spotify selbst bestreitet jede Beteiligung. Den einzig rechtlich halbwegs sauberen Ursprung hat das Free Music Archive Dataset, das 2016 von der Schweizer EPFL zusammengestellt wurde. Es basiert überwiegend auf Creative-Commons-Lizenzen und dient seit Jahren als Benchmark in der Audioforschung. Konzerne wie Google und Stability AI haben in ihren Dokumentationen offengelegt, Teile davon genutzt zu haben.
AI Watchdog stellt allerdings klar: Das Vorkommen eines Titels in diesen Katalogen beweist zunächst nur, dass er im Fundus verfügbar war – nicht zwingend, dass jedes einzelne Modell tatsächlich damit trainiert wurde. Doch die Indizienkette schließt sich an anderer Stelle: Im Rechtsstreit mit der RIAA räumte der KI-Anbieter Suno selbst ein, sein Modell mit „Zehrmillionen frei im Netz zugänglichen Aufnahmen“ gefüttert zu haben (Rolling Stone). Angebot und Nachfrage passen hier nahtlos zusammen.
Vom Star bis zum Bedroom-Producer: Fassungslosigkeit und Galgenhumor
Die Reaktionen der Musikszene nach dem Start der Datenbank schwankten zwischen ohnmächtiger Wut und purem Galgenhumor.
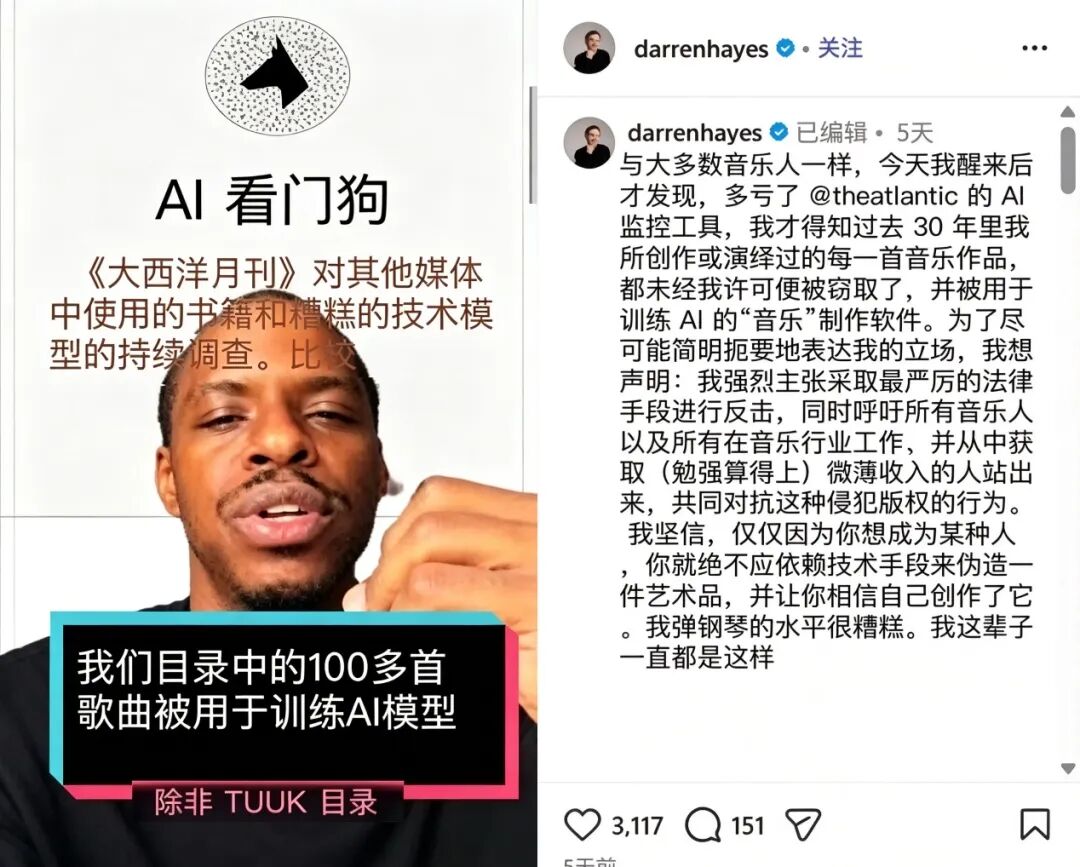
Darren Hayes, früherer Sänger von Savage Garden, beklagte, dass buchstäblich jedes Werk seiner 30-jährigen Karriere von Algorithmen abgegriffen worden sei. Dean Ormston, Chef der australischen Verwertungsgesellschaft APRA AMCOS und amtierender CISAC-Vorsitzender, warf den KI-Firmen vor, das Schaffen von Ikonen wie Midnight Oil, Sia, Crowded House oder Lorde schamlos auszuschlachten (Bericht; Ormstons Rolle per Billboard).
SZA griff Star-Produzent Diplo direkt an: Sie warf ihm vor, Anteile an Suno zu halten und zuzusehen, wie das System mit dem Schaffen schwarzer Künstler gefüttert werde. Sie sprach von kultureller Ausbeutung: „Wir stellen 13 Prozent der US-Bevölkerung, prägen aber die Musik weltweit. Ich habe noch keinen weißen KI-Song gehört. Weder Gesetzgeber noch das Gesundheitssystem schützen uns – wir sind die leichteste Beute“ (Variety).
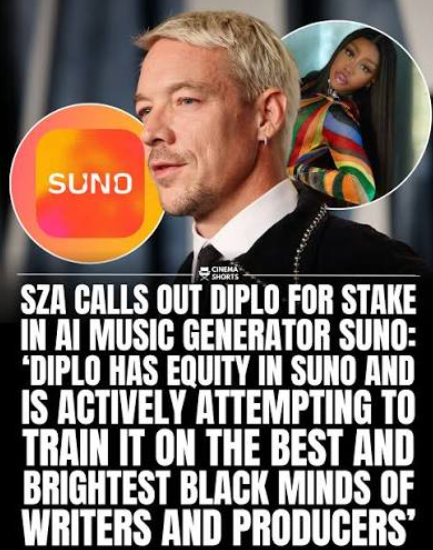
Bei Diplo lohnt eine Differenzierung: Ob er tatsächlich Anteile an Suno hält, ist laut Variety unbestätigt; belegt ist lediglich sein Investment in das KI-Startup Aaru. Seine Haltung ist dennoch radikal pragmatisch: Im April erklärte er, gegen KI lasse sich ohnehin nichts ausrichten, er brauche für Produktionen keine menschlichen Stimmen mehr und Kollegen sollten sich anpassen – „oder eben Taxi fahren, bis autonome Autos übernehmen“ (Variety). Sunos Produktchef Jack Brody wiegelte derweil ab: Man speichere keine Künstlernamen in den Metadaten, das System könne Originale nicht 1:1 nachahmen und man arbeite ständig an besseren Filtern gegen Imitationen (Variety).
Deutlich drastischere Worte fand Hip-Hop-Produzent Kenny Beats auf X: „Ihr seid erbärmliche Verlierer. Wie kann man morgens zur Arbeit gehen und wissen, dass man unzählige Musiker bestiehlt, die um ihre Existenz kämpfen?“ Sein Fazit fiel entsprechend unmissverständlich aus (Rolling Stone).
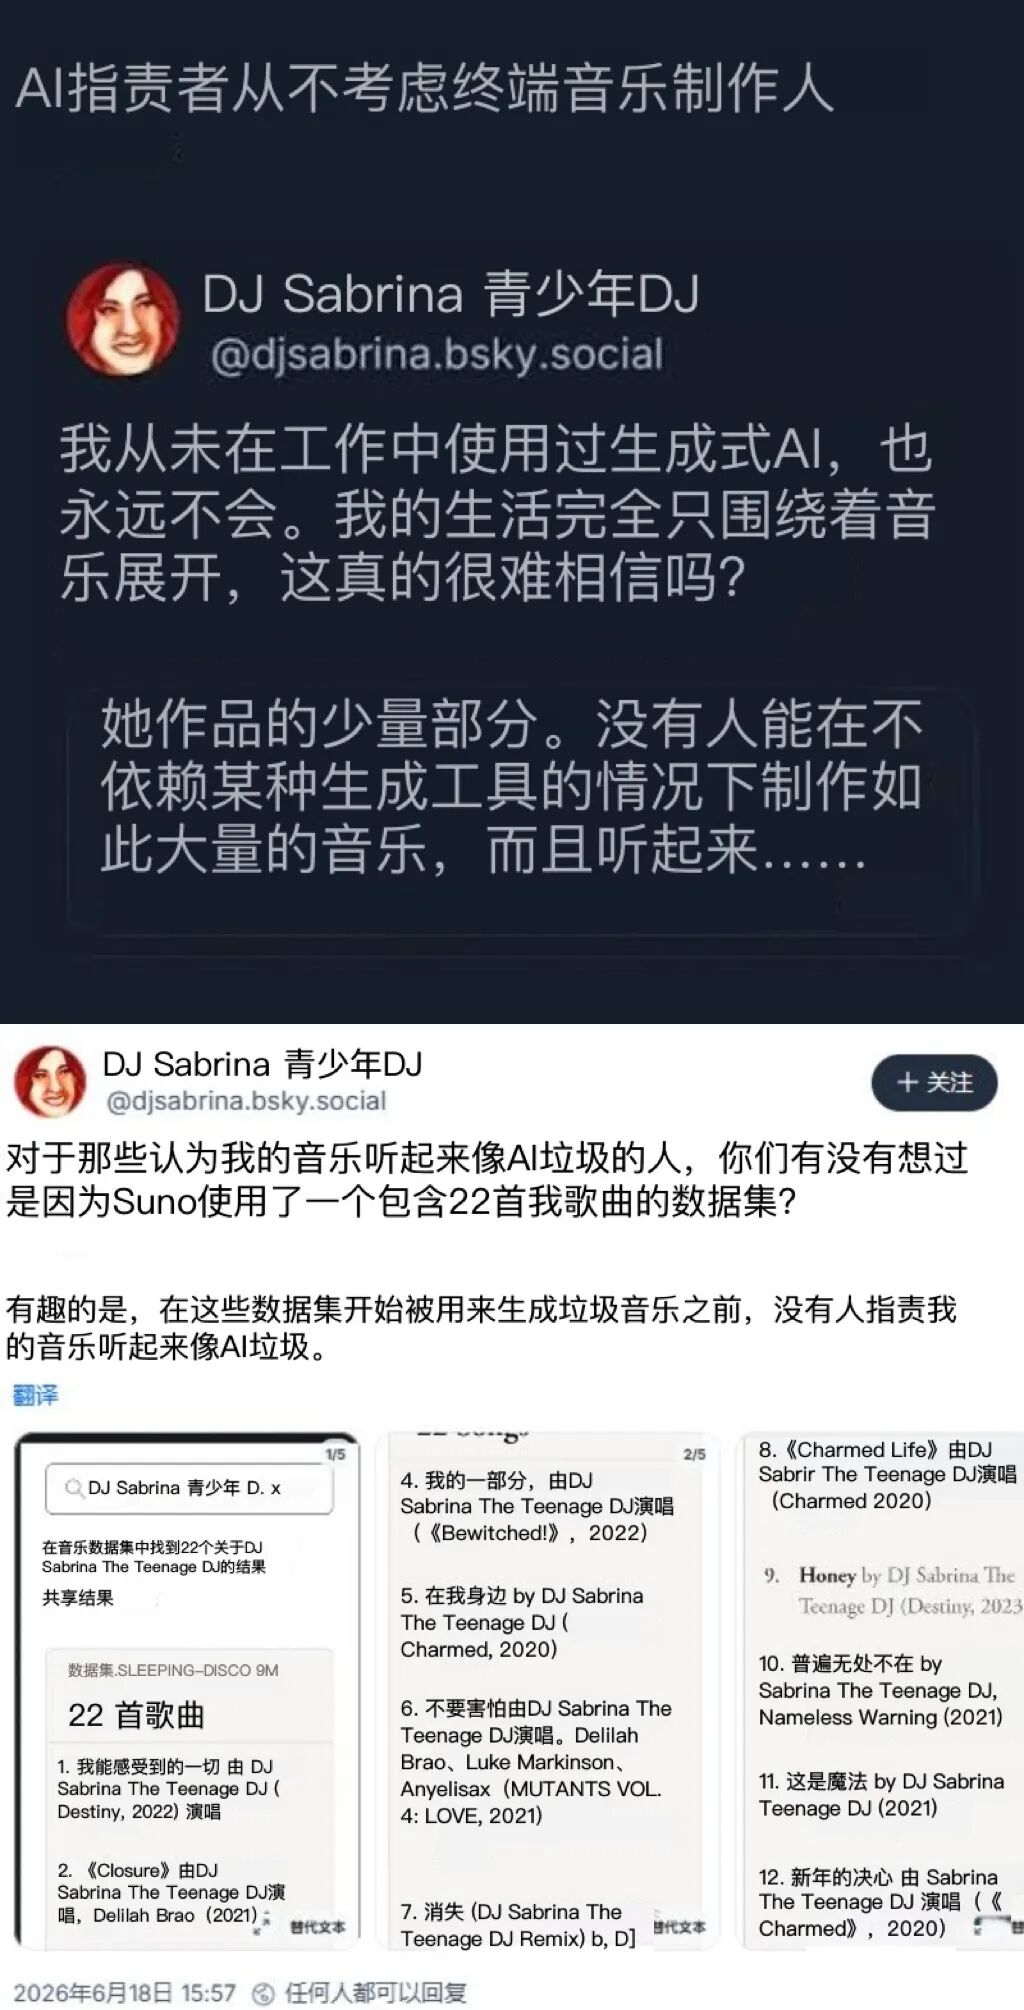
In der Indie-Szene kippte die Stimmung schnell in schwarzen Humor. Die Musikerin DJ Sabrina the Teenage DJ fand 22 eigene Tracks im Corpus und kommentierte auf Bluesky trocken: „Vielleicht klingt meine Musik für manche Leute nur deshalb wie KI-Müll, weil Suno mit 22 meiner Stücke trainiert wurde?“ Der Frontmann von Titus Andronicus spottete: „Sie haben B-Seiten von Alben gescrapt, die kein Mensch gehört hat – viel Erfolg damit.“ Auf Reddit schrieb ein Nutzer: „Mein Song ist dabei – und mich kennt absolut niemand!“ (Bericht).
Darin liegt die bittere Pointe: Für Weltstars bedeutet das Training ungefragte Verwertung ihres Marktwerts; für Nischenmusiker ist es eine absurde Form von Beachtung – endlich wird die eigene Musik entdeckt, allerdings von einem Webcrawler statt von einem menschlichen Hörer. Ein Label-Manager gestand gegenüber dem Rolling Stone sogar, selbst auf einen KI-Künstler hereingefallen zu sein: Er sei ins Büro gestürmt und habe gefragt, warum man dieses Ausnahmetalent bisher übersehen habe (Rolling Stone).
Der Spaltpilz bei den Majors: Klagen auf der einen, Lizenzen auf der anderen Seite
Während Künstler protestieren, schaffen die Musikkonzerne längst Fakten. Und die Strategien der großen drei Labels – Universal, Sony und Warner – könnten kaum unterschiedlicher sein.
Im Juni 2024 standen sie im Verbund der RIAA noch geschlossen da: Sie reichten massive Klagen wegen Urheberrechtsverletzungen gegen Suno und Udio ein.
Am 29. Oktober 2025 scherte Universal Music (UMG) als Erstes aus: Der Konzern schloss einen Vergleich mit Udio und kündigte eine gemeinsame, lizenzierte Plattform an. Das neue Udio soll 2026 starten und ausschließlich Werke von UMG-Künstlern nutzen, die dem aktiv zustimmen. Nutzer dürfen die Musik in einem geschlossenen Ökosystem remixen, die Songs die Plattform aber nicht verlassen. Am Tag der Verkündung strich Udio prompt die Download-Funktion ein – was wütende Proteste zahlender Abonnenten auf Reddit auslöste, bis das Unternehmen für 48 Stunden ein Einsehen hatte (Billboard). Am 19. November zog Warner Music nach und einigte sich ebenfalls mit Udio (Billboard); am selben Tag vermeldete Suno eine 250-Millionen-Dollar-Finanzierungsrunde bei einer Bewertung von 2,45 Milliarden Dollar (Billboard). Kurz darauf ging Warner noch weiter und fand auch mit Suno eine Einigung: Suno verpflichtet sich, alte Modelle abzuschalten und neue Systeme nur auf Basis lizenzierten Materials aufzubauen.
Damit hat sich Warner mit beiden KI-Riesen arrangiert. Universal einigte sich nur mit Udio und klagt gegen Suno weiter. Sony verhandelt mit keinem von beiden. Udio wiederum kauft sich derweil systematisch Legitimität ein: Im Januar 2026 sicherte sich die Plattform einen Deal mit dem Indie-Verband Merlin (Billboard), am 9. April folgte eine Partnerschaft mit dem Verlag Kobalt (Billboard). Ein typisches Bild: Mit der einen Hand prozessieren, mit der anderen Hand Lizenzen einsammeln.
Doch diese Deals werfen eine neue Bruchlinie auf: Wer sieht das Geld? Am 5. Juni 2026 verklagte die US-Musikergewerkschaft AFM Universal und Warner. Der Vorwurf: Die Labels lizenzierten Aufnahmen an KI-Firmen, ohne die ausübenden Musiker zu vergüten oder sie überhaupt darüber zu informieren, welche Kataloge freigegeben wurden (Billboard).
Am 22. Juni schlug eine internationale Allianz aus Künstlern und Managern in einem offenen Brief Alarm: Die Labels pochten gegenüber KI-Entwicklern zu Recht auf Lizenzen, verweigerten ihren eigenen Urhebern aber dasselbe Mitspracherecht. Viele Musiker wurden ungefragt per Opt-in-Verfahren eingebunden, in neuen Plattenverträgen tauchen KI-Abtretungsklauseln bereits als Standard auf (Billboard). Kurz: Die Labels haben die Verwertungsrechte an sich gerissen – und die Schöpfer stehen außen vor.
Münchner Paukenschlag: Urheberrecht schlägt KI-Ambitionen
Sah es im Frühjahr 2026 noch so aus, als würde sich der Konflikt in Vergleichen auflösen, brachte ein Urteil vom 31. Juli die Wende.
Das Landgericht München I entschied, dass Suno gegen deutsches Urheberrecht verstoßen hat. Die Plattform hatte zahlreiche von der GEMA vertretene Titel – darunter Evergreens wie „Rasputin“ von Boney M., „Forever Young“ von Alphaville oder Lou Begas „Mambo No. 5“ – ohne Lizenz und Vergütung für das Training verwendet. Das Gericht sprach der GEMA Schadensersatz dem Grunde nach zu. GEMA-Chef Tobias Holzmüller fand klare Worte: Wer KI-Modelle auf Diebstahl geistigen Eigentums aufbaue, genieße keinen gesetzlichen Schutz. Suno wies das Urteil zurück, sprach von einem Missverständnis seiner Technologie und prüft Rechtsmittel (Billboard).
Parallel verschärfte sich die juristische Lage in den USA. Universal und Sony nutzten Warners Deal mit Suno gegen den Anbieter selbst: Wenn Suno nun Geld für Musik zahle, existiere offensichtlich ein regulärer Lizenzmarkt – womit sich das Unternehmen nicht mehr auf das Prinzip des „Fair Use“ (angemessene Verwendung) berufen könne. Suno versuchte vergeblich, die Details des Warner-Deals vor Gericht unter Verschluss zu halten (Billboard).
Am 9. September brachte Suno sein Modell v6 an den Start – beworben als partnerschaftliche Lösung mit Material von Warner, BMG und Believe. Vorgängermodelle wurden vereinbarungsgemäß stillgelegt, Downloads begrenzt (Billboard). Warner-CEO Robert Kyncl feierte das in einem internen Memo als Etappensieg und formulierte seine Doktrin: „Licensing, Litigation, Legislation“ – Verhandeln, Klagen und Regulieren müssen Hand in Hand gehen (Billboard).
Die Antwort von Universal und Sony folgte postwendend: Am 18. September erweiterten sie ihre Klage um weitere 61.000 Songs und bezeichneten v6 als „Frucht des vergifteten Baumes“. Das Argument: Das neue Modell wurde unter anderem mit den Ausgaben und Nutzerdaten der alten Modelle trainiert. Synthetische Daten würden den ursprünglichen Urheberrechtsverstoß nicht heilen, sondern lediglich verschleiern (Billboard).
Doch nicht alle teilen diese strenge Sicht: Tori Noble von der Electronic Frontier Foundation (EFF) verweist darauf, dass Rechteinhaber keinen künstlichen Lizenzmarkt erfinden dürfen, wo das Gesetz Fair Use erlaubt. Ähnlich wie in Klagen von Buchautoren gegen Anthropic haben US-Gerichte bereits signalisiert, dass reines Training unter Ausnahmen fallen könnte (Billboard). Die Rechtslage in den USA bleibt eine fundamentale Wette.
Vom Pauschalpreis zur Zurechnung: Wer baut das neue Abrechnungssystem?
Während Gerichte streiten, formiert sich hinter den Kulissen ein völlig neues Geschäftsfeld: die Monetarisierung von Trainingsdaten.
Die Zahlen sprechen Bände: Laut Daten von Global Info Research lag das weltweite Marktvolumen für KI-Trainingsdaten 2025 bei rund 1,847 Milliarden US-Dollar. Bis 2032 soll es auf 11,458 Milliarden Dollar anwachsen (jährliches Plus von 29,7 Prozent); andere Schätzungen gehen von bis zu 23,18 Milliarden Dollar bis 2034 aus (diese Werte sind mit Vorsicht zu genießen). Der Trend ist eindeutig: Daten werden zum teuersten Rohstoff der KI-Ära.
Das Kernproblem des alten Urheberrechts: Es rechnet pro Nutzung oder Abruf ab. Ein KI-Modell saugt einen Song jedoch einmalig auf, behält dessen stilistische Muster für immer und generiert daraus unendlich viele neue Werke. Das klassische Tantiemensystem greift hier nicht mehr.
Einen ersten Ausweg zeigte die schwedische Verwertungsgesellschaft STIM am 9. September 2026: Sie schloss mit dem KI-Startup Songfox und dem Analyseunternehmen Sureel den ersten kollektiven KI-Lizenzvertrag ab. Das Modell staffelt die Vergütung in drei Stufen: eine Vorabzahlung für das Training, eine prozentuale Beteiligung am Unternehmensumsatz und eine Beteiligung an konkreten KI-Titeln, die auf den lizenzierten Werken basieren. Jeder Song muss aktiv freigegeben werden; die Einnahmen teilen sich Komponisten und Produzenten halbe-halbe. Sureel liefert die Technologie zur Zurechnung („Attribution“). STIM sieht darin eine Blaupause nach dem Vorbild der Streaming-Wende: Illegale Nutzung verfolgen, aber gleichzeitig funktionierende Lizenzwege schaffen (Billboard).
Die Grundlagen dafür legte die Forschung: Ein Paper von Sony AI („Attribution-by-design“, Oktober 2025) schlug bereits vor, zwischen Trainings- und Inferenz-Ebene zu unterscheiden. Forscher der University of Illinois Urbana-Champaign skizzierten im Konzept „Computational Copyright“ ein System ähnlich wie bei Spotify oder YouTube, bei dem algorithmisch ermittelt wird, wie stark ein Original ein generiertes Stück beeinflusst hat. Was vor kurzem noch Theorie war, wandert nun in Verträge.
Gleichzeitig sichern sich die Labels ab: Sonys Dance-Label B1 Recordings ließ sich in neuen Verträgen bereits „unbeschränkte, exklusive Rechte“ zur Nutzung von Masteraufnahmen für generative KI-Systeme zusichern. Anwälte warnen, dass Labels sogar alte Universalklauseln zweckentfremden könnten, um Songs ohne gesonderte Einwilligung an KI-Labore weiterzureichen (Billboard).
Milliardenschaden für Urheber: Die düstere CISAC-Prognose
Wie hoch der finanzielle Schaden für Musiker tatsächlich ist, zeigt eine Studie der Beratungsgesellschaft PMP im Auftrag des Dachverbands CISAC (November 2024): Bis 2028 könnte generative KI den Urhebern jährlich rund 4 Milliarden Euro entziehen – das entspricht knapp 24 Prozent der weltweiten Verteilungssumme der Verwertungsgesellschaften. Der Markt für KI-generierte Musik selbst dürfte bis dahin auf 16 Milliarden Dollar anwachsen (Billboard). ABBA-Legende und CISAC-Präsident Björn Ulvaeus brachte es auf den Punkt: KI-Erfolge basierten nicht auf gemeinfreiem Material, sondern auf geschütztem Eigentum – es brauche faire Bedingungen.
Besonders hart trifft es funktionale Musik: Laut der Studie (Bericht) dürften KI-Tracks bis 2028 rund 20 Prozent der Streaming-Erlöse und bis zu 60 Prozent der Einnahmen aus Musikbibliotheken für Werbe- und TV-Produktionen vereinnahmen. Genau diese „Gebrauchsmusik“ in Kaufhäusern, Clips und Dokus sichert jedoch tausenden Instrumentalisten die Existenz. Wenn dieses Fundament wegbricht, können sich viele Musiker nicht einmal mehr die Studiomiete leisten (Billboard).
Die bitterste Erkenntnis des Reports: Ohne strikte Regulierungsreformen werden Musiker an den Milliardengewinnen der generativen KI schlicht nicht beteiligt. Sie verlieren doppelt – durch unbezahltes Datentraining und durch billigere KI-Klone, die sie am Markt verdrängen.
Ausblick: Der Kampf um Stil, Stimme und Verteilung
Parallel formiert sich der Widerstand auf gesetzlicher Ebene: Der ELVIS Act im US-Bundesstaat Tennessee schützt seit 2024 die Stimmen von Musikern vor Deepfakes (Billboard); auf Bundesebene nimmt der NO FAKES Act Gestalt an (Billboard). Im Juni 2026 brachten US-Abgeordnete den CREATOR Act ein, der auch den individuellen künstlerischen Stil vor ungefragter KI-Nachahmung schützen soll – eine Dimension, die das klassische Werkurheberrecht bislang kaum abdeckt (Bericht).
Auch Streamingdienste ziehen Grenzen: TIDAL kündigte Ende Juni an, reine KI-Titel gesondert zu kennzeichnen und von der Monetarisierung auszuschließen. Spotify und Apple Music experimentieren mit ähnlichen Filtern (Rolling Stone). Gleichzeitig zeigt sich, dass KI-Musik längst in den Charts angekommen ist: Der mit Suno produzierte Track „Let Me Be“ stand sechs Wochen an der Spitze der US-Afrobeats-Charts von Billboard, und der virtuellen KI-Künstlerin Xania Monet wurde ein Plattenvertrag über 3 Millionen Dollar angeboten – was Kollegin Kehlani mit sichtlicher Verachtung quittierte (Billboard).
Das Jahr 2026 markiert damit einen historischen Wendepunkt: Das Urteil des Landgerichts München setzt dem ungezügelten Datenklau Grenzen; Universal und Sony machen mit neuen Klagen deutlich, dass kosmetische Neuanfänge wie Suno v6 juristisch nicht ziehen; Warner zeigt, dass Lizenzen und Rechtsstreit parallel laufen können; und Pionierprojekte wie das von STIM beweisen, dass Vergütung technisch abbildbar ist – auch wenn Gewerkschaften und Urheberverbände noch immer darum kämpfen müssen, dass das Geld tatsächlich bei den Musikern ankommt.
Die Debatte dreht sich längst nicht mehr darum, ob man KI in der Musik verhindern kann. Es geht um knallharte Ökonomie: Wie wird Trainingsmaterial bewertet, wie wird Zurechnung nachgewiesen und wer bekommt welches Stück vom Kuchen? Die neuen Spielregeln der Musikbranche werden nicht mehr nur im Studio geschrieben – sondern Zeile für Zeile in den Lizenzverträgen des KI-Zeitalters.
Quellen
- 音乐先声 (Music First Sound): 《音乐圈版权保卫战:AI是如何洗劫音乐人的?》 (original article, in Chinese)
- Rolling Stone: Have Artists Reached Their Breaking Point With AI?
- Variety: SZA Slams 'Disgusting' Musicians Using AI, Says Platforms Like Suno Train on the 'Best and Brightest Black Minds of Writers and Producers'
- Billboard: UMG-Udio Deal FAQ: What Questions Remain About the AI Agreement That's Shaken Up the Music Biz?
- Billboard: Warner Music Settles With Udio, Signs Deal for Licensed AI Music Platform
- Billboard: Udio Strikes AI Licensing Deal With Merlin for Independent Labels
- Billboard: Udio and Kobalt Ink Partnership
- Billboard: Musicians Union Sues UMG, WMG Over AI Settlements: 'Refused to Provide Compensation'
- Billboard: Musicians Pen Letter, Warning About AI Music Deals: 'Innovation Cannot Be Used to Override Artists' Rights'
- Billboard: Suno Held Liable for Infringing German Song Copyrights in Landmark Court Ruling
- Billboard: Danish Rights Group Koda Sues Suno for 'Biggest Theft in Music History'
- Billboard: Licenses Versus Lawsuits: Why Suno's Parallel Legal Strategies May Pose a 'Conundrum'
- Billboard: UMG & Sony Hit Suno With New Lawsuit After Label-Backed Model: 'Fruit of the Same Poisoned Tree'
- Billboard: Suno Launches First AI Music Models 'in Partnership With the Music Industry'
- Billboard: Warner Music Group CEO Pens Memo About Suno Partnership: 'This Is a Smart Win'
- Billboard: As Some Labels Strike Deals With Suno, Artist Reps Sound Off: 'It's the Wild, Wild West'
- Billboard: STIM Explores AI Music Licensing Framework With Songfox Deal: 'This Is a Blueprint'
- Billboard: Will Generative AI Become a Creator Terminator?
- Billboard: CISAC Elects APRA AMCOS CEO Dean Ormston as New Chair
- Billboard: Tennessee Adopts ELVIS Act, Protecting Artists' Voices From AI Impersonation
- Billboard: NO FAKES Act Returns to Congress With Support From YouTube, OpenAI for AI Deepfake Bill
- Billboard: Kehlani Slams AI Artist Xania Monet Over $3 Million Record Deal Offer: 'I Don't Respect It'