
懂克制、会呼吸,AI音乐的“尤里卡时刻”到了?
更新于:
第一遍惊艳,第二遍就想切歌——这大概是很多人听AI音乐时的共同感受。
问题往往不在复杂度不够,反而是太满了。为了证明自己什么都会,鼓点要密,和声要厚,情绪全程拉满,每一轨都在拼命刷存在感,听下来只觉得用力过猛。真正会写歌的人都懂,什么时候不演奏才是关键:先铺垫、再留白,情绪有起伏,高潮落下来才站得住。
前阵子引发争议的AI“改编版”Bubble(《泡沫》)就是个例子,作品下架、创作者也道了歉。抛开版权争议不谈,很多人的反感在于,AI版几乎抹掉了原曲的情绪曲线,连带着层次和张力一起丢了。而版权的边界本身也在重写:2025年1月29日,美国版权局发布的报告明确,只有当人类作者决定了足够的表达性元素,生成式AI的产出才能受版权保护,光写提示词是不够的。U.S. Copyright Office
平心而论,这几年AI音乐一直在努力听起来更像人。早期的人声模型整首歌像一口气唱到底是常态,现在已经能模拟换气和停顿,情绪也有了点变化,进步是实打实的。但愿意反复听的AI歌依然很少,因为模型还没学会真正的克制,整首歌的情绪起伏跟人写的东西比,差距还很明显。
当“能不能写出一首完整歌”不再是门槛,行业的竞争自然就从生成转向作曲了。这里的作曲是两层意思:模型能不能拿出接近人类制作水准的作品;产品能不能给音乐人真正趁手的工具,而不是只丢过来一首听着很满的成品。
国产AI音乐平台Mureka最近发布的V9.5,是我近段时间看到的、少见的同时在这两个方向上都往前走了一步的版本。按照官网的说法,V9.5让旋律、和声、编曲更自然,人声表现和风格覆盖也更好了。Mureka V9.5 official page
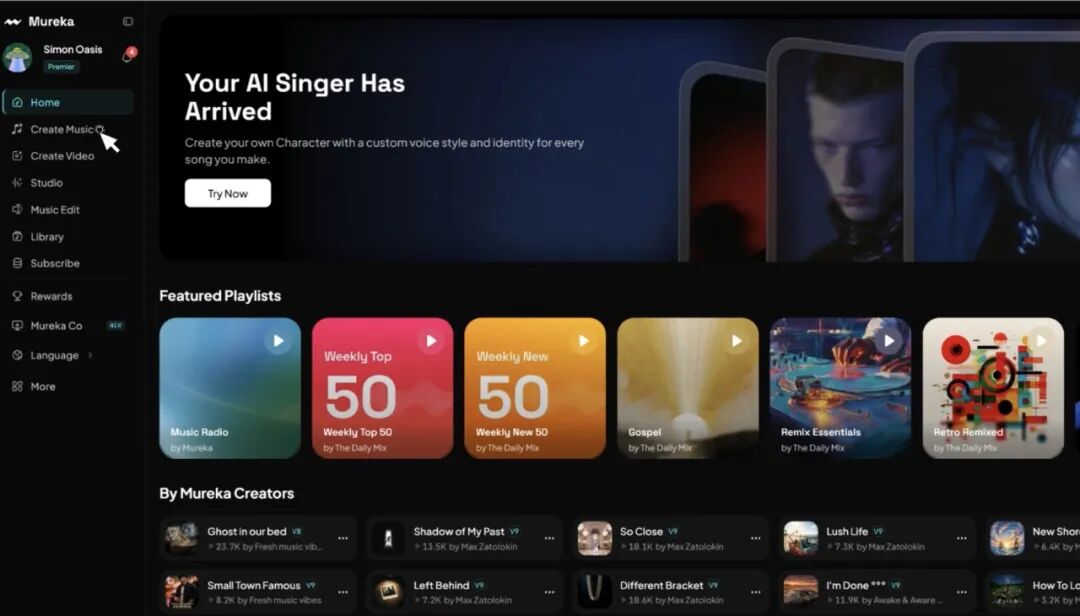
它的口号是“True to music. Open to every idea.”,不再卷“更满、更复杂”,转而强调克制、留白、情绪,以及创作者对音乐的掌控。这和Mureka那句“Eureka Flows, Music Grows.”其实是一脉相承。
那么,从能生成到懂作曲,AI音乐是不是真到了属于自己的尤里卡时刻?
AI音乐,开始懂留白了
过去两年,AI音乐最重要的进展,是先解决了能不能生成一首完整歌的问题。
但大模型能力趋同之后,这本身已经没什么稀奇了。现在大家会用听正常音乐的标准来挑剔AI歌:有感觉吗?有记忆点吗?值得二刷吗?供给侧的变化更夸张。Deezer在2026年7月公布的数据显示,2026年6月高峰时,平台每天收到近9万首纯AI生成的歌曲,占当天新增上传的一半以上,可实际播放量只占平台的1%到3%。能生成和有人反复听,完全是两回事。Deezer Newsroom
短板也越来越藏不住:乐器大杂烩、编曲过度设计、混音填得太满、人声卷到超出人类极限——几乎每个元素都在忙着证明“我存在”。
带着这些问题,我们上手实测了Mureka刚发布的Mureka V9.5模型。
测下来最意外的一点是,Mureka V9.5好像真的开始理解作曲了。它不再把“更满更复杂”当唯一目标,音乐懂得张弛了,更接近人写歌的逻辑,而且提示词和成品之间的对应关系明显更可控了。
比如之前用V9生成过的Give Me a Little More Time(《再给我多一点时间》),这次歌词一个字没动,我们只重写了提示词:
"Ambient Lo-Fi atmosphere, 70 BPM slow tempo, built on Rhodes electric piano and analog synths with tape-saturation character, supported by delicate urban folk guitar, a minimal kick, and rain samples — aiming for a slow, restrained electronic ballad mood carrying the loneliness of late night."
生成的结果,比预想中有意思。
先说音色和质感。Mureka V9.5对复古Lo-Fi的理解明显更完整了:Rhodes电钢的暖、磁带饱和带来的轻微过载和模拟味,都很自然地化在整体声音里,而不是把几个风格标签硬贴上去。
直观的感受是,提示词和结果对得上了。当创作者在提示词里描述氛围、速度和情绪时,模型能把这些抽象的想法比较稳定地落到具体的音乐选择上,而不是抓两三个风格词就交差。
编曲逻辑上也是如此:即便提示词里没明说,Mureka V9.5也不再一味求满,开始主动管理编曲的密度了。
在我们的测试曲Eureka(《尤里卡》)里听得最明显,人声进来和桥段过渡的地方,明显把空间让给了主旋律。伴奏不再全程铺满频段,声部之间懂得给彼此留呼吸感,情绪是跟着歌曲推进长起来的,而不是从第一小节就顶满。
人声侧的变化也值得单拎出来说。
拿小样The Life We Make来说,很多AI音乐模型的人声处理习惯是存在感拉满——靠厚音色、全程顶满来表现“精致”,Mureka V9.5反而收着唱,更克制,也更可信。
细听能发现,咬字没那么用力,演唱也更松弛。这种改动第一耳未必抓人,但气口、气声、咬字和语气这些细节真正参与到了情绪表达里,整首歌的情绪线也更自然了。
编曲更克制、创意意图还原更准、人声更自然,其实都指向同一个问题:AI到底是怎么开始理解一首歌的整体作曲逻辑的?
这就得往技术层再挖一层了。
很多AI音乐模型还是边想边写的路子,一边生成一边预测下一段,整轨出得快,但因为没有全局结构规划,段落衔接容易生硬,情绪起伏不均,有时候编曲和人声甚至各唱各的。
Mureka V9.5延续并打磨了MusiCoT(Music Chain of Thought)这套思路,更接近真实的音乐制作流程:先不定具体的旋律配器人声,而是把整首歌的结构框架搭好——段落怎么分、情绪曲线怎么走、动态哪里起哪里收,哪里留白哪里推——再围着这个大框架往下生成。公开的MusiCoT研究页面也提到,研究者从100首歌曲中抽了10组随机样本,和基础模型、Suno V4、Udio V1.5以及Mureka V5.5做了对比。MusiCoT research page
从结果看,提升不是某个听感维度单点变好了,而是整首歌的完成度更接近真正的作曲逻辑了。编曲、人声和提示词不再是生成时各碰运气,而是开始服务于同一个更连贯的音乐叙事。
当行业开始聊留白、情绪起伏、提示词还原度和复听价值,AI音乐的评判标准,其实已经越来越接近音乐本身的标准了。
AI音乐的“尤里卡时刻”
对创作者来说,过去大多数AI音乐工具的生成模式都很眼熟,本质上就是抽卡式作曲。
Mureka对创作者理解最明显的变化就在这。从单次生成走向多版本创作,实际体验下来能感到分工变了:模型负责降低结果的不确定性,产品负责放大创作者的决策空间,把更多控制权还给做音乐的人。
某种意义上,Mureka是在把AI从生成内容推向培育想法——这就是AI音乐的尤里卡时刻。
“尤里卡时刻”来自希腊语heurēka,意思是“我找到了”。它常用来形容苦找很久之后,突然找到关键答案、灵感被点亮的一瞬间。这说的其实就是作曲本身。难的往往不是把歌写下来,而是在无数模糊的感觉、旋律和半成品想法里,撞见那个就是它了的瞬间。
模型层面,Mureka想把“好听”变成可控、可复现、可越用越好的系统能力。分段歌词语义、人声演绎和情绪的匹配、音乐结构和语义推进的关系,都被收进同一套优化框架里了。
但模型够强之后,真正有意思的问题会浮到产品层。比多生成几首好歌更重要的,是创作者能不能在不同版本之间有效挑选。所以Mureka接下来的产品能力,得连起来看才有味道。
比如Character & MV,创作者只要给一张照片加一小段人声采样,就能得到一个“长相+声音”绑定的虚拟形象,后续作品里可以反复调用,慢慢长成一个更完整的数字身份。
Soundtrack解决的是创作链路上的另一道缝。以前视频创作者都是片子剪完了,再去大海捞针找一首差不多的BGM;现在AI能跟着画面场景、运动和情绪直接参与配乐了。
我们实测的Growing Up(《长大》)配乐就是如此,生成的音乐完全跟着影像叙事走,随画面推进而变化,而不是检索一段风格接近的底乐糊上去。
而Mureka Co更接近专业音乐流程里的关键一步。它能直接进Ableton Live这类DAW环境,用自然语言建轨道、定BPM、挂效果,整曲、单轨都能生成,还能做分轨分离和节拍对齐。
这对职业创作者尤其重要。执行交给AI,判断留给人,生成和制作不再是两个世界的事了。
看到这里,变化已经很难忽视了。Mureka在搭的是一套完整的AI原生创作平台。
新手可以用对话智能体或自定义模式,从词、曲、人声一路做到成品;内容创作者可以给图文、视频配乐,做AI音乐视频;职业制作人则能带着Studio、多轨编辑、分轨导出和Mureka Co,扎进DAW流程里抠细节。
整条链路,从最初的灵感到生成、打磨、做视频、专业收尾全包了。一个想法可以在平台上快速发散,再跨不同版本去控制和执行,而创作者手里留下的,恰恰是最难被自动化的部分:审美判断、取舍选择和最终表达。
所以只比V9.5的小样是不是比别家模型更惊艳,量不出Mureka真正的差别在哪。
写在最后
这么看,Mureka已经不只是一个纯粹的AI音乐生成工具,更接近AI音乐时代的创作基建:它连起来的不只是模型和成品,还有灵感、生成、编辑到发布的整条链。
不一样的是,它服务的创作者、生产方式和内容形态,都更AI原生。
这也意味着,AI音乐下一阶段的竞争,可能不再只是模型之间的竞争,而是创作入口的竞争。
未来真正要抢的,不只是谁生成的歌更好听,而是谁成为创作者习惯性打开的那个工具——想法从冒头到生成、修改、打磨,再到成品,都能在这里走完。
模型能力当然还是重要的,它决定了AI音乐产品的上限。但模型差距越收越窄之后,能不能留住人,可能要看工作流顺不顺手、创作自由度够不够,以及平台能不能接住创作者越来越复杂的需求。
模型决定能力上限,工作流决定创作体验,平台最终抢的是创作者的习惯。