
Um acervo de 21 milhões de faixas: como uma simples barra de busca virou do avesso a relação da música com a IA
Atualizado:
No final de junho de 2026, a cantora SZA, vencedora do Grammy, publicou um Story no Instagram com o print de uma pesquisa perturbadora: "Acabei de checar. A IA foi treinada com 238 músicas minhas. Tenho certeza de que algumas nem foram lançadas." O desabafo veio em tom enfático: "Se você é músico e apoia essa palhaçada decadente? Você é NOJENTO e NÃO EXISTE NADA QUE VOCÊ POSSA ME DIZER que torne isso aceitável." (Rolling Stone)
Essa checagem só foi possível graças ao projeto AI Watchdog, encabeçado por Alex Reisner na revista The Atlantic. Naquele mês de junho, a publicação expandiu suas investigações — que já cobriam livros, artigos acadêmicos e vídeos — para o universo musical, catalogando grandes bases de dados de áudio que circulavam livremente entre desenvolvedores de IA e criando um sistema de busca público. O resultado foi uma corrida generalizada de auditoria própria por todo o ecossistema musical global, mobilizando desde associações de classe e vencedores do Grammy até artistas independentes desconhecidos: a ferramenta cataloga obras de mais de 250.000 artistas. A cantora Kehlani também fez a busca e expôs seus números na web: 179 faixas no banco de dados (Rolling Stone).
O estrago causado por um campo de busca tão simples tem explicação direta: pela primeira vez, uma zona cinzenta que pairava silenciosa sobre a indústria foi escancarada na cara dos criadores. Suas produções já viraram matéria-prima bruta para desenvolvedores de IA rasparem e utilizarem à vontade — e ninguém se deu ao trabalho de avisar.
Uma barra de pesquisa escancara o que ninguém queria ver
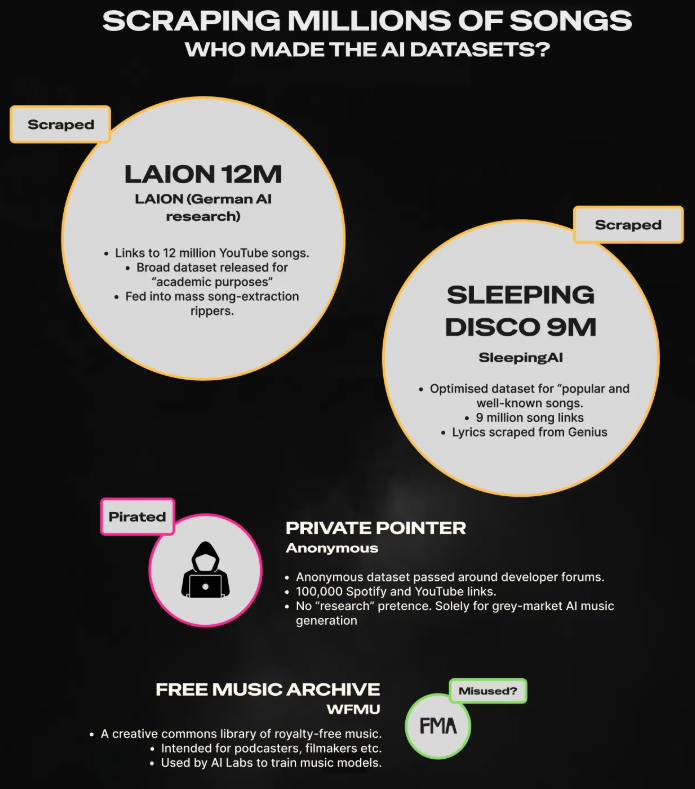
O AI Watchdog nasceu em 2025 como uma iniciativa investigativa da The Atlantic focada em rastrear a procedência de direitos autorais em dados de treinamento de IA. Segundo apuração detalhada no artigo original sobre o trabalho da revista, os quatro conjuntos de dados musicais revelados incluem dois gigantes — o LAION-DISCO-12M (com 12 milhões de faixas) e o Sleeping-DISCO-9M (9 milhões de faixas) — além de dois intermediários com mais de 100.000 gravações cada: o Spotify Tracks Dataset e o Free Music Archive Dataset. Somados, passam com folga de 21 milhões de registros.
A apuração da Rolling Stone confirma o peso do maior deles: o LAION-DISCO-12M, lançado em novembro de 2024 pela organização sem fins lucrativos alemã LAION, reúne mais de 12 milhões de canções raspadas do YouTube com metadados estruturados para "apoiar a pesquisa fundamental de aprendizado de máquina em modelos de base, recuperação de informação musical e análise de datasets de áudio". Para quem não ligou o nome à pessoa: essa mesma organização compilou a base de imagens que deu origem ao Stable Diffusion (Rolling Stone).
Em comunicado oficial repercutido pela cobertura original, a LAION reforça que o LAION-DISCO-12M serve "exclusivamente para fins acadêmicos", vedando o uso comercial. Só que, na prática, essa trava teórica esbarra no vácuo jurídico e na velocidade de propagação do ecossistema open-source: uma vez liberado na rede, o destino desses dados foge totalmente do controle de quem os publicou. O outro catálogo gigante, Sleeping-DISCO-9M, é ainda mais explícito: ele extraiu conteúdo do YouTube e letras do Genius, usando ferramentas como cloudscraper para contornar bloqueios da Cloudflare e correlacionar letras, metadados e links — um verdadeiro pacote pronto para pré-treinar modelos generativos de áudio.
No caso do Spotify Tracks Dataset, o calcanhar de aquiles é a falta de rastreabilidade: faixas raspadas do Spotify foram parar na plataforma Hugging Face pelas mãos de um desenvolvedor anônimo, levando o Spotify a negar publicamente qualquer envolvimento. Já o Free Music Archive Dataset é o único do grupo com origem formal documentada: foi montado em 2016 pela EPFL (Escola Politécnica Federal de Lausanne) a partir do acervo do Free Music Archive, composto majoritariamente por licenças Creative Commons e adotado historicamente como referência em pesquisas de processamento de áudio. Google e Stability AI já confirmaram em suas documentações técnicas o uso de fatias dessa base.
O próprio AI Watchdog faz duas ressalvas essenciais: essas quatro bases não cobrem todo o universo de dados usados para treinar sistemas generativos, e a presença de uma música na lista não é prova cabal de que determinado modelo a processou. A plataforma atesta "disponibilidade", não o "uso final". Só que há outro dado decisivo nessa conta: em manifestações judiciais nos processos movidos pela RIAA, a Suno admitiu que seu modelo foi alimentado com "dezenas de milhões de gravações" disponíveis publicamente na web (Rolling Stone). Agora, o tamanho da represa e o volume de água consumido finalmente começam a bater.
A onda de checagens: fúria, ironia e o "reconhecimento" via crawler
Na semana em que o mecanismo de busca entrou no ar, a reação dos artistas transitou entre a fúria visceral e o humor mais ácido.
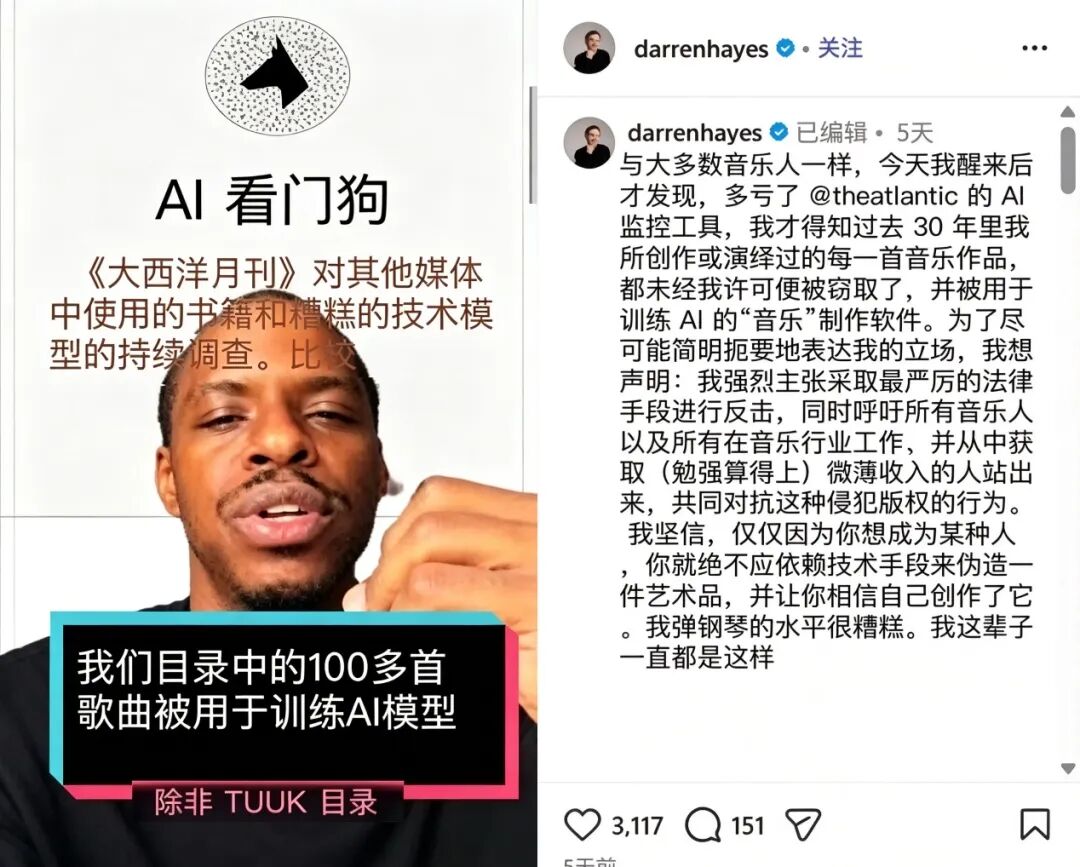
Darren Hayes, vocalista do Savage Garden, desabafou afirmando que tudo o que compôs ou gravou nos últimos 30 anos foi surrupiado por softwares de IA. Dean Ormston — presidente da entidade de arrecadação australiana APRA AMCOS e atual presidente do conselho da CISAC (a confederação internacional de sociedades de autores) — declarou abertamente que as desenvolvedoras estão se apropriando de criações de nomes como Midnight Oil, Sia, Crowded House e Lorde (conforme reportagem original; liderança de Ormston na CISAC via Billboard).
SZA, por sua vez, personificou o debate. Ao acusar o produtor Diplo de "ter participação na Suno" e "tentar treiná-la com as melhores mentes negras entre compositores e produtores", levou a questão para a esfera da exploração cultural: "Somos 13% da população dos EUA e influenciamos o mundo inteiro com nossas vozes e perspectivas. Ainda não ouvi uma única música de IA branca… Não temos proteção nas leis, na saúde ou na criatividade — somos os mais fáceis de roubar." (Variety)
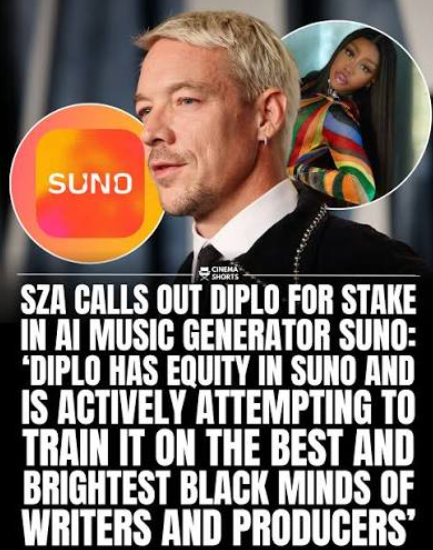
Vale pontuar uma precisão factual importante aqui: relatos anteriores diziam que Diplo "esclareceu que não tinha ações da Suno". No entanto, a checagem da Variety revelou que sua participação na Suno nunca foi formalmente esclarecida; o que se confirmou foi seu aporte em outra startup de IA, a Aaru. O ponto central, contudo, é sua visão: em abril, o produtor disse que "não adianta lutar contra a IA", afirmou que não precisa mais de vocalistas humanos porque consegue "a melhor voz via IA" e aconselhou músicos avessos à tecnologia a "se adaptarem ou desistirem de vez para virar motoristas de Uber até que todo mundo tenha um Waymo" (Variety; corrigindo a imprecisão sobre a "resposta oficial" citada no artigo base). Na mesma esteira, o chefe de produto da Suno, Jack Brody, rebateu dizendo que os metadados de treino não contêm nomes de artistas, que o modelo não replica faixas de treinamento e que a ferramenta aprimora continuamente a detecção de imitações (Variety).
O produtor Kenneth Blume, o Kenny Beats, foi direto ao ponto no X: "Vocês são uns verdadeiros perdedores. Não consigo imaginar ir trabalhar todo dia sabendo que você está roubando de inúmeros músicos que mal conseguem pagar as contas." E arrematou com um sonoro desabafo mandando todos se danarem (Rolling Stone).
No cenário independente, a reação descambou para o nonsense. A produtora DJ Sabrina the Teenage DJ encontrou 22 faixas suas na base e fez troça no Bluesky: "Será que o pessoal que diz que o meu som parece lixo de IA já parou pra pensar que talvez seja porque a Suno usou uma base de dados com 22 faixas minhas?" O vocalista do Titus Andronicus preferiu o humor melancólico: "Pegaram lados B obscuros de um disco que ninguém ouviu… boa sorte pra eles." Já no Reddit, um usuário comentou: "Achei minha própria música lá — e eu não sou famoso nem um pouco!" (conforme o artigo original).
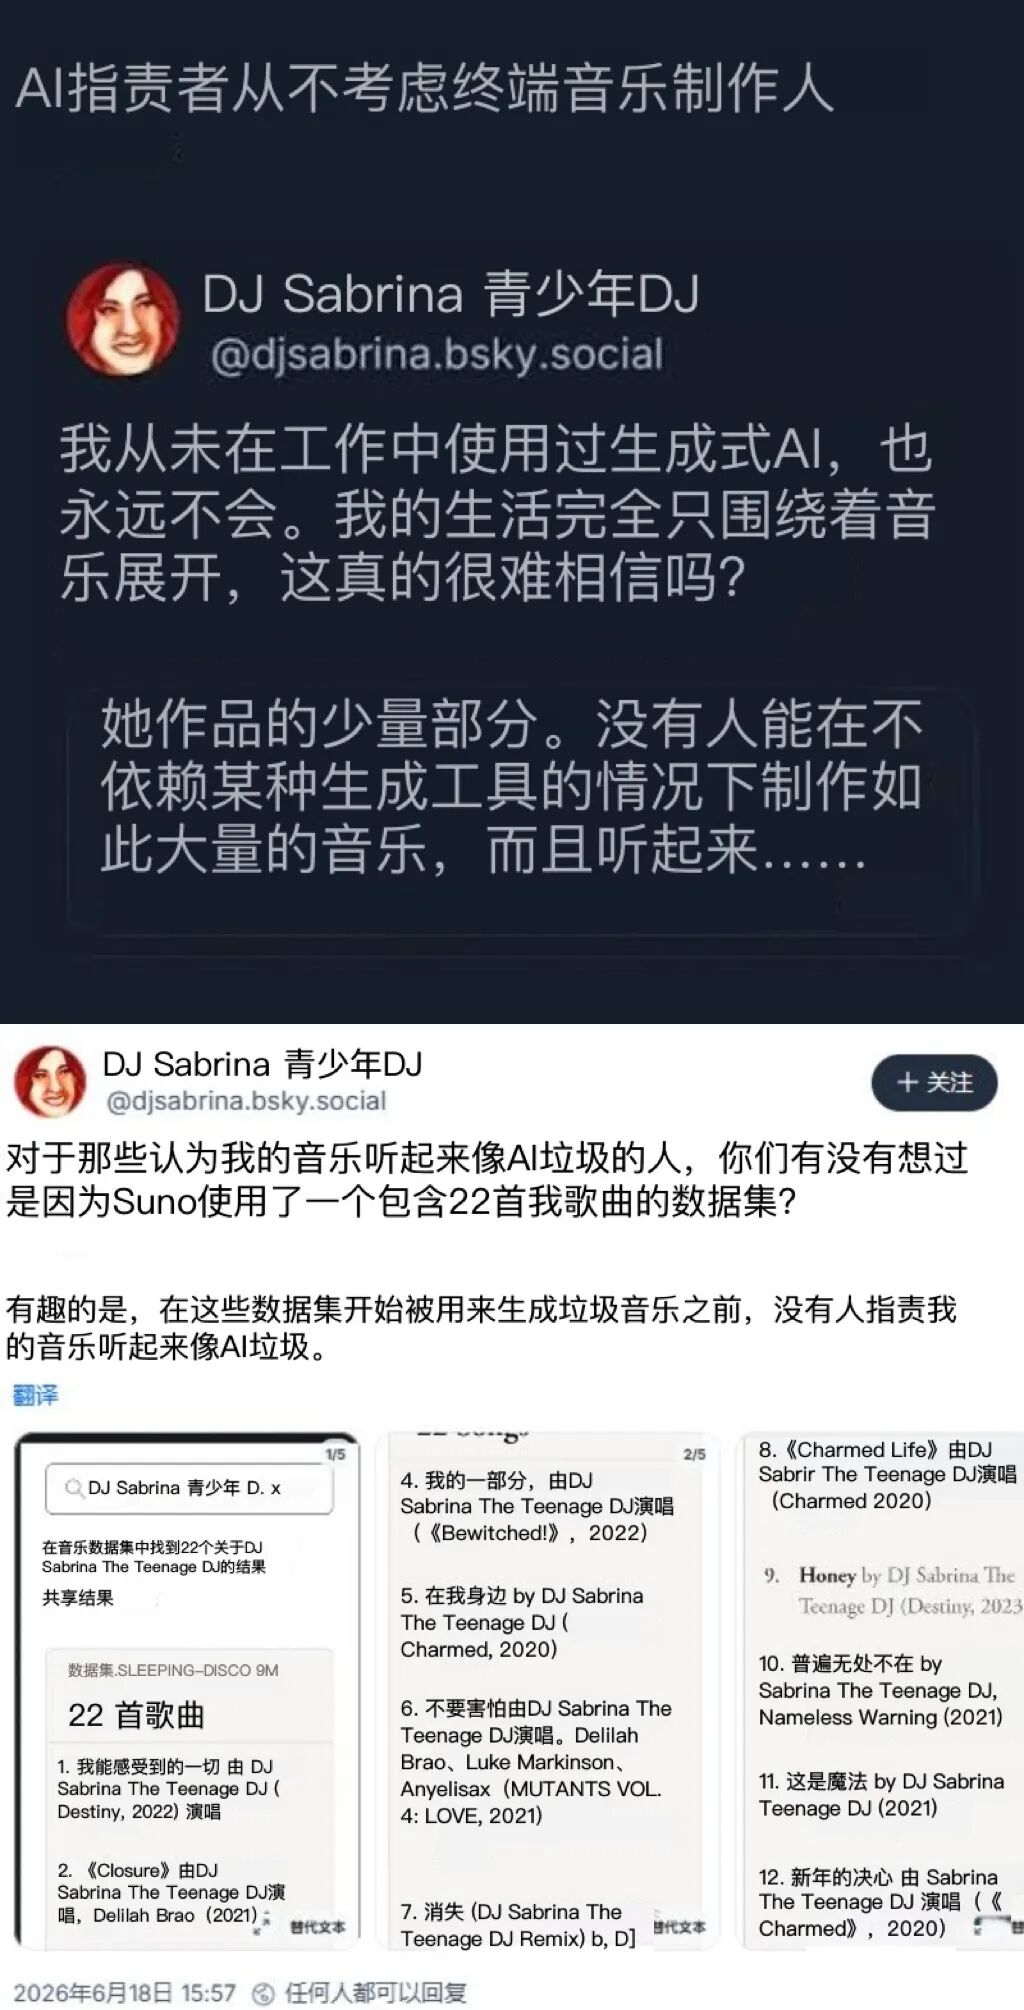
É aí que o cenário se torna cruel. Para artistas do topo, trata-se de apropriação indevida de capital comercial. Para quem está na base, a sensação é de uma visibilidade distorcida: a obra finalmente foi descoberta por alguém — só que por um algoritmo de raspagem, não por ouvintes humanos. Há uma inversão completa de papéis: a IA digere o trabalho do artista e, em seguida, o mercado passa a julgar o próprio artista a partir da régua estética da máquina. A confusão é tão generalizada que um executivo de distribuição admitiu à Rolling Stone ter caído na pegadinha de um projeto feito por IA, invadindo a sala da sua equipe cobrando por que diabos aquele talento novo ainda não tinha sido contratado (Rolling Stone).
O racha das majors: conciliação de um lado, cobrança do outro
Para além dos desabafos na internet, quem dita o rumo do mercado é a movimentação do capital. E, ao longo dos últimos meses, as três gigantes da indústria musical adotaram estratégias completamente divergentes.
Tudo começou em junho de 2024, quando Universal, Sony e Warner, representadas pela RIAA, processaram conjuntamente Suno e Udio por violação massiva de direitos autorais, acusando as startups de clonarem catálogos sem qualquer tipo de autorização.
Em 29 de outubro de 2025, a Universal rompeu o bloco: fechou um acordo abrangente com a Udio, encerrando a disputa judicial e anunciando o desenvolvimento de uma plataforma conjunta de música com IA devidamente licenciada. O modelo previa que a nova Udio estrearia em 2026 utilizando apenas conteúdos de artistas da UMG que aceitassem participar, funcionando num ecossistema fechado de onde as criações não poderiam ser exportadas. No mesmo dia do anúncio, a Udio removeu a opção de download para os usuários, gerando revolta imediata no Reddit; 72 horas depois, a empresa recuou e concedeu uma janela de 48 horas para downloads (Billboard). Em 19 de novembro, a Warner seguiu o mesmo caminho e firmou sua parceria com a Udio (Billboard); nessa mesma data, a Suno revelou uma rodada de US$ 250 milhões, atingindo avaliação de US$ 2,45 bilhões (Billboard). Fechando o mês, a Warner foi além e se acertou também com a Suno, impondo que a plataforma desenvolvesse um novo modelo restrito a faixas licenciadas e desativasse o antigo.
Com isso, a Warner se tornou a única major a fazer as pazes com Suno e Udio ao mesmo tempo. A Universal negociou só com a Udio e manteve o litígio aberto contra a Suno. A Sony, por sua vez, recusou acordos com ambas. Paralelamente, a Udio seguiu comprando seu passe de entrada na indústria: assinou em janeiro de 2026 com a Merlin, união das gravadoras independentes (Billboard), e fechou em 9 de abril uma aliança com a gigante da edição independente Kobalt (Billboard) — mostrando que as plataformas de IA brigam nos tribunais com uma mão enquanto correm para assinar contratos com a outra.
Só que esses acordos não resolveram o repasse aos artistas — na verdade, abriram uma crise interna inédita. Em 5 de junho de 2026, a American Federation of Musicians (AFM), sindicato dos músicos instrumentistas dos EUA, processou Universal e Warner: a entidade acusa as gravadoras de licenciarem fonogramas com participações de seus filiados sem repassar um centavo sequer, sem dar os devidos créditos e sonegando até a lista das faixas negociadas (Billboard).
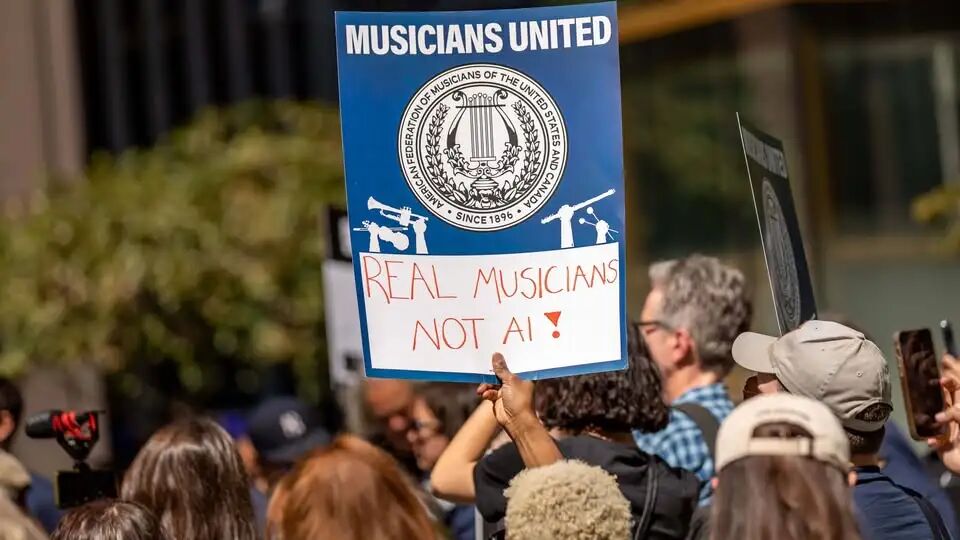
Logo depois, em 22 de junho, uma coalizão internacional de artistas, compositores e empresários publicou uma carta aberta contundente: gravadoras e editoras "argumentam com razão que empresas de IA precisam de licença para usar seus catálogos, mas negam esse mesmo direito de escolha a seus artistas e autores". Muitos profissionais relataram terem sido incluídos compulsoriamente nesses pacotes de IA, com cláusulas de cessão para inteligência artificial virando exigência padrão em novos contratos de gravação (Billboard). Em termos simples: as gravadoras decidiram quem autoriza o uso, embolsaram o dinheiro e deixaram os criadores do lado de fora da partilha.
A sentença de Munique e a teoria do fruto envenenado
Se os acordos no primeiro semestre de 2026 pareciam indicar uma pacificação pragmática do mercado, uma sentença proferida em 31 de julho jogou gasolina na fogueira — exatamente um mês após a publicação do artigo original.
O Tribunal Regional de Munique condenou a Suno por violar a lei de direitos autorais da Alemanha ao alimentar seus sistemas com dezenas de obras locais administradas pela GEMA — clássicos como "Rasputin" do Boney M., "Forever Young" do Alphaville e "Mambo No. 5" de Lou Bega — sem autorização prévia e sem pagamento, determinando indenização por perdas e danos (ainda a ser calculada, cabendo recurso). Trata-se de uma das primeiras grandes derrotas judiciais de uma empresa de música por IA no mundo. Tobias Holzmüller, CEO da GEMA, foi taxativo: "A justiça deixou cristalino hoje: modelos de IA erguidos sobre o roubo de propriedade intelectual não contam com a proteção da lei." A Suno declarou que a decisão "baseia-se em uma compreensão equivocada do funcionamento de sua tecnologia" e estuda recorrer (Billboard).
Do outro lado do Atlântico, os processos americanos ganharam contornos ainda mais complexos. A partir de abril de 2026, Universal e Sony passaram a usar o acordo entre Suno e Warner como prova material de que o treinamento de modelos afeta diretamente o mercado comercial — o pilar mais frágil da tese de fair use (uso aceitável) defendida pelas big techs: afinal, se a Warner licencia esse material mediante pagamento, esse mercado já existe e a Suno é cliente dele. A Suno, em contrapartida, tentou impedir judicialmente o acesso aos termos do contrato com a Warner, alegando que o acordo decorreu de risco processual, e não de dinâmicas livres de mercado (Billboard).
Em 9 de setembro, a Suno colocou no ar a versão v6 do seu algoritmo, anunciada como um marco "em parceria com a indústria musical" — desenvolvida com catálogos licenciados de Warner, BMG, Believe e outros parceiros, com divisão de receitas, descontinuação da versão anterior conforme o trato e travas em downloads (Billboard). Em memorando interno, o CEO da Warner, Robert Kyncl, celebrou o resultado como uma "vitória estratégica" e resumiu o método da empresa no tripé dos "três Ls": licensing (licenciamento), litigation (litígio) e legislation (legislação) — operando nas três frentes sem abrir mão de nenhuma (Billboard).
A reação da Universal e da Sony demorou apenas nove dias: em 18 de setembro, protocolaram uma nova ação conjunta contra a Suno, anexando mais 61.000 músicas ao processo e definindo a nova versão v6 como fruto da mesma árvore envenenada. O argumento é técnico: além do material licenciado, o modelo v6 foi treinado com dados sintéticos derivados das interações e resultados dos modelos anteriores — o que, juridicamente, equivaleria a "lavar" o aprendizado obtido de forma ilícita no passado. A nova petição usou os próprios acordos da Suno contra ela: ao se tornar compradora assídua de licenças, a empresa não pode mais alegar perante o juiz que esse mercado não existe (Billboard).
O debate, contudo, divide especialistas. Tori Noble, advogada da Electronic Frontier Foundation (EFF), defende a posição da Suno com base nos precedentes de disputas envolvendo a Meta, considerando essa a interpretação mais sólida da lei: "Do contrário, detentores de direitos poderiam inventar licenças artificiais sobre coisas que não têm o direito exclusivo de controlar… seria como permitir que alguém cobrasse entrada para um parque público." No campo literário, por exemplo, juízes federais já acataram argumentos favoráveis à indústria de IA na tese de uso aceitável para treino de dados (Billboard). A aplicação do fair use a modelos de IA segue em aberto nos EUA — e é exatamente sobre essa indefinição que as empresas estão apostando bilhões.
Reescrevendo as regras: de royalties de treinamento à tecnologia de atribuição
Enquanto os tribunais acertam as pendências do passado, a verdadeira disputa do futuro é sobre como dividir as receitas operacionais. No instante em que dados viraram negócio bilionário, a indústria precisou criar uma nova contabilidade.
Os números em jogo impressionam: segundo dados da consultoria Global Info Research citados na apuração original, o mercado global de datasets para treino de IA movimentou cerca de US$ 1,847 bilhão em 2025 e deve alcançar US$ 11,458 bilhões até 2032, crescendo 29,7% ao ano; outras projeções chegam a estimar US$ 23,18 bilhões para 2034 (estimativas de mercado que devem ser analisadas com cautela metodológica). Divergências à parte, o diagnóstico é inequívoco: conjuntos de dados se tornaram o ativo de negociação mais valioso da era generativa.
O desafio estrutural dessa nova fase é que o modelo tradicional de direitos autorais foi pensado para o consumo unitário ("tocou, pagou"). O treinamento de IA, por outro lado, absorve e destila a faixa na arquitetura do modelo de uma só vez, ecoando seus padrões infinitamente em produções futuras. A remuneração precisa, portanto, ser desmembrada em etapas.
Quem apresentou o modelo operacional pioneiro nessa frente foi a STIM, entidade sueca de gestão coletiva de direitos musicais. Em 9 de setembro de 2026, firmou a primeira licença coletiva de IA da indústria musical em parceria com a Songfox e a empresa de tecnologia de atribuição Sureel. Conforme apurou a Billboard, o arranjo divide a remuneração em três momentos: pagamento inicial pela cessão dos dados de treino, participação nas receitas gerais da plataforma de IA e repasse proporcional sobre as faixas geradas que se basearem nas obras do catálogo. A adesão é facultativa (opt-in), os ganhos são divididos igualmente (50/50) entre autores e titulares de gravações, e a Sureel faz a auditoria algorítmica de atribuição. A STIM classificou o acordo como "um modelo de referência", traçando paralelo com o surgimento do streaming: "ir atrás de quem comete infrações, mas também oferecer uma rota legal para quem quer operar corretamente" (Billboard).
Esse formato vinha sendo desenhado pela comunidade acadêmica e por centros de pesquisa corporativos. Conforme registrado no artigo original, um estudo publicado por pesquisadores da Sony AI em outubro de 2025 ("Attribution-by-design") propôs separar a atribuição no momento do treinamento da atribuição no momento da geração em tempo real, viabilizando rastreabilidade de procedência e divisão de royalties. Antes disso, um artigo da Universidade de Illinois Urbana-Champaign ("Computational Copyright") já sugeria adotar uma mecânica inspirada no YouTube e no Spotify: medir o grau de influência de cada faixa original sobre a música gerada pela IA e calcular o repasse proporcional. O fato de a STIM incorporar uma empresa dedicada a essa tecnologia em seus contratos prova que as teorias de laboratório finalmente viraram cláusulas contratuais.
Na ponta inicial da cadeia, as gravadoras já estão se blindando: a Billboard revelou que novos contratos artísticos passaram a embutir cessão ampla de direitos para IA. O selo eletrônico B1 Recordings, da Sony, incluiu cláusulas que exigem "direitos exclusivos e ilimitados" para usar gravações em "sistemas generativos de inteligência artificial… inclusive no treinamento de modelos". Advogados renomados do setor alertam que gravadoras podem se apoiar em termos genéricos de contratos antigos (os mesmos usados para autorizar áudio no TikTok ou no Instagram) para despejar catálogos inteiros em modelos de IA sem consultar os artistas (Billboard). A distribuição financeira está sendo renegociada em duas vias simultâneas: os milhões que as startups de IA pagam às gravadoras e os novos termos contratuais que as gravadoras tentam impor aos seus próprios músicos.
Qual o tamanho do estrago? O alerta da CISAC para a próxima década
Mas qual é, afinal, o impacto financeiro real sobre os autores? O levantamento mais aprofundado sobre o tema foi encomendado pela CISAC à consultoria de estratégia PMP (divulgado em novembro de 2024): até 2028, a IA generativa deve subtrair cerca de € 4 bilhões por ano de compositores e detentores de direitos — o equivalente a 24% de tudo o que é recolhido pelas entidades de gestão coletiva globalmente. No mesmo intervalo, a própria indústria de música sintética por IA deve atingir uma receita anual de US$ 16 bilhões (Billboard). Björn Ulvaeus, vocalista do ABBA e presidente da CISAC, foi certeiro durante a apresentação do estudo: "O sucesso da IA não foi construído em cima de dados públicos desprotegidos — foi construído em cima de obras protegidas por direitos autorais. Precisamos exigir uma divisão justa."
As estimativas do estudo repercutidas no texto base apontam que, até 2028, conteúdos criados por IA vão abocanhar 20% das receitas das plataformas de streaming e abocanhar brutais 60% do mercado de música funcional para bibliotecas de áudio. As primeiras vítimas dessa substituição não são os grandes lançamentos do pop, mas o ecossistema de trilhas e som ambiente voltado a restaurantes, lojas e pequenas produções audiovisuais. Um articulista da Billboard resumiu com precisão o perigo: a produção funcional é justamente o que garante o sustento e o fluxo de caixa de milhares de músicos de estúdio — "se essa renda minguar, como é que esses instrumentistas vão conseguir pagar as horas de estúdio para gravar seus projetos autorais?" (Billboard)
A frase mais dura do relatório resume o nó górdio: "Se o arcabouço regulatório permanecer inalterado, os criadores não verão um tostão da revolução da IA generativa." A classe artística enfrenta uma pinça financeira perfeita: perde receitas quando suas obras são mineradas sem autorização e, em seguida, tem seu espaço tradicional de trabalho canibalizado pelos próprios conteúdos sintéticos gerados por essas ferramentas. Não é à toa que o desabafo de SZA se resume a três perguntas fundamentais: Quem deu autorização para isso? Quem está lucrando com essa máquina? E se o talento humano virou a espinha dorsal da tecnologia, por que o músico segue excluído da divisão do bolo?
Conclusão: as novas regras estão sendo escritas nos detalhes
A proteção jurídica da identidade vocal e estilística tornou-se outra frente crucial dessa batalha. Nos Estados Unidos, o estado do Tennessee aprovou em 2024 a ELVIS Act, blindando a voz de cantores contra clonagens por IA (Billboard), enquanto o projeto federal NO FAKES Act avança no Congresso americano (Billboard). Conforme apontou o relato original, legisladores dos EUA propuseram em junho de 2026 a CREATOR Act para artes visuais, permitindo que ilustradores barrem o uso e exijam indenização caso sistemas de IA mimetizem comercialmente seus estilos artísticos característicos sem consentimento — já que as leis tradicionais cobrem obras específicas, mas não protegem "estilos" (proposta legislativa registrada na cobertura base sem outras confirmações públicas em inglês). Embora a maioria dessas leis esteja em estágio inicial, a tendência é nítida: tirar o direito sobre o estilo autoral dos debates conceituais e colocá-lo no código de leis.
Os serviços de streaming também foram forçados a se posicionar. Em 29 de junho, o TIDAL anunciou que passará a identificar e rotular faixas produzidas essencialmente por IA — materiais sinalizados continuam na plataforma, mas perdem direito à monetização do pool de assinantes; iniciativas semelhantes de identificação foram anunciadas por Spotify e Apple Music (Rolling Stone). E vale notar que a música sintética já saiu da fase experimental amadora: "Let Me Be", uma faixa completada com a Suno, passou seis semanas na liderança da parada Billboard US Afrobeats Songs, enquanto a artista virtual Xania Monet recebeu uma proposta de contrato de gravação de US$ 3 milhões — manobra que Kehlani criticou publicamente com desdém: "Não respeito isso" (Billboard).
Juntando todas as peças deste tabuleiro em 2026, o panorama fica evidente: a Justiça de Munique estabeleceu um precedente crucial ao fixar que uso sem licença é infração; Universal e Sony mostraram com novos processos que acordos de gaveta não limpam modelos retroativos; a tática dos "três Ls" da Warner provou que litigar, licenciar e fazer lobby legislativo caminham lado a lado; o contrato pioneiro da STIM provou que é viável criar regras para treino, assinatura e saídas de áudio; e as ações sindicais da AFM e da coalizão de artistas alertam que as receitas fechadas pelas gravadoras ainda não chegaram a quem realmente compõe.
Tudo isso evidencia que a grande discussão do setor já mudou de patamar: o dilema não é mais "se devemos enfrentar a IA", mas sim "como precificar e quem recebe a conta". O verdadeiro campo de batalha dos próximos anos não estará nos discursos acalorados dos tribunais, mas nos detalhes técnicos de treinamento, rastreabilidade, geração algorítmica e divisão de centavos. A era da inteligência artificial exige muito mais do que remendos na legislação de direitos autorais: exige um modelo contábil inteiramente novo para a música — e esse livro-caixa está sendo disputado linha por linha.
Fontes
- 音乐先声 (Music First Sound): 《音乐圈版权保卫战:AI是如何洗劫音乐人的?》 (original article, in Chinese)
- Rolling Stone: Have Artists Reached Their Breaking Point With AI?
- Variety: SZA Slams 'Disgusting' Musicians Using AI, Says Platforms Like Suno Train on the 'Best and Brightest Black Minds of Writers and Producers'
- Billboard: UMG-Udio Deal FAQ: What Questions Remain About the AI Agreement That's Shaken Up the Music Biz?
- Billboard: Warner Music Settles With Udio, Signs Deal for Licensed AI Music Platform
- Billboard: Udio Strikes AI Licensing Deal With Merlin for Independent Labels
- Billboard: Udio and Kobalt Ink Partnership
- Billboard: Musicians Union Sues UMG, WMG Over AI Settlements: 'Refused to Provide Compensation'
- Billboard: Musicians Pen Letter, Warning About AI Music Deals: 'Innovation Cannot Be Used to Override Artists' Rights'
- Billboard: Suno Held Liable for Infringing German Song Copyrights in Landmark Court Ruling
- Billboard: Danish Rights Group Koda Sues Suno for 'Biggest Theft in Music History'
- Billboard: Licenses Versus Lawsuits: Why Suno's Parallel Legal Strategies May Pose a 'Conundrum'
- Billboard: UMG & Sony Hit Suno With New Lawsuit After Label-Backed Model: 'Fruit of the Same Poisoned Tree'
- Billboard: Suno Launches First AI Music Models 'in Partnership With the Music Industry'
- Billboard: Warner Music Group CEO Pens Memo About Suno Partnership: 'This Is a Smart Win'
- Billboard: As Some Labels Strike Deals With Suno, Artist Reps Sound Off: 'It's the Wild, Wild West'
- Billboard: STIM Explores AI Music Licensing Framework With Songfox Deal: 'This Is a Blueprint'
- Billboard: Will Generative AI Become a Creator Terminator?
- Billboard: CISAC Elects APRA AMCOS CEO Dean Ormston as New Chair
- Billboard: Tennessee Adopts ELVIS Act, Protecting Artists' Voices From AI Impersonation
- Billboard: NO FAKES Act Returns to Congress With Support From YouTube, OpenAI for AI Deepfake Bill
- Billboard: Kehlani Slams AI Artist Xania Monet Over $3 Million Record Deal Offer: 'I Don't Respect It'