Spartiti in testo puro: cosa ci insegna il jukebox piratesco di Claude sulle capacità musicali degli LLM
Aggiornato:
C'è una scheda del browser da cui escono sei motivi che sembrano usciti dritti da un'avventura grafica dei primi anni '90. Nessun file audio registrato, nessun campione: ogni traccia è un semplice file di testo, interpretato nota per nota da un sintetizzatore Web Audio essenziale. Il dettaglio più interessante? Sia gli spartiti testuali sia il sintetizzatore sono opera di un modello linguistico.
L'esperimento porta la firma dello sviluppatore Simon Willison. Il 6 ottobre 2026 ha lanciato una sfida a Claude Opus 5.5 chiedendogli tre cose: inventare un formato testuale minimale per comporre musica da videogame, scrivere un player dedicato e inserire qualche brano dimostrativo. Il punto di riferimento richiesto era esplicito: le musiche del primo The Secret of Monkey Island. È nato così Scrimshaw Jukebox. Willison ha ammesso che il modello ha calcato la mano sull'ambientazione caraibica e piratesca ben oltre le sue intenzioni, ma ha definito il risultato «sorprendentemente buono».
Una singola demo non fa una rivoluzione, e Willison è il primo a non voler trarre conclusioni affrettate. Eppure, l'architettura di questo esperimento rivela dinamiche preziose su come i modelli linguistici gestiscano le strutture musicali e su quanto ci sia ancora da chiarire.
L'architettura del formato ideato dal modello
La parte più intrigante dell'esperimento risiede proprio nella sintassi del formato, documentata in dettaglio nella pagina del tool.
- Il ritmo come calcolo puro. Ciascuna battuta è suddivisa in un numero fisso di step. Una nota come
D5dura un singolo step; ogni trattino aggiunto ne prolunga la durata (D5---equivale quindi a quattro step). Il punto indica invece una pausa. - Metro definito da due parametri. Impostando
beats 4esteps 4si ottiene un 4/4 in sedicesimi;beats 2consteps 3genera una giga in 6/8, mentrebeats 3consteps 2imposta il tempo di un valzer. Un valore diswingapplica il caratteristico ritardo a step alternati. - Notazione armonica semplificata. Sigle come
[Dm7]o[C/E]vengono armonizzate automaticamente attorno all'altezza assegnata a ciascuna voce. - Percussioni a griglia. La traccia ritmica sfrutta un carattere per ogni step (come
x... ..x.), dovexrappresenta il colpo principale eouna ghost note. - Struttura formale esplicita. Lo spartito definisce prima i pattern (i blocchi di battute), poi specifica una riga
playper l'intro e una rigaloopper la sezione destinata a ripetersi all'infinito, proprio come nelle colonne sonore dei videogiochi. L'istruzioneB*2ripete una sezione, mentreA+2traspone il pattern di un tono intero.
Il player integra 65 strumenti sintetizzati: steel drum, marimba, clavicembalo, tuba, cori e percussioni a mano. L'interfaccia mostra ogni partitura sotto forma di piano roll, consente di silenziare i singoli canali e permette all'utente di modificare il codice sorgente per riascoltare all'istante le variazioni.
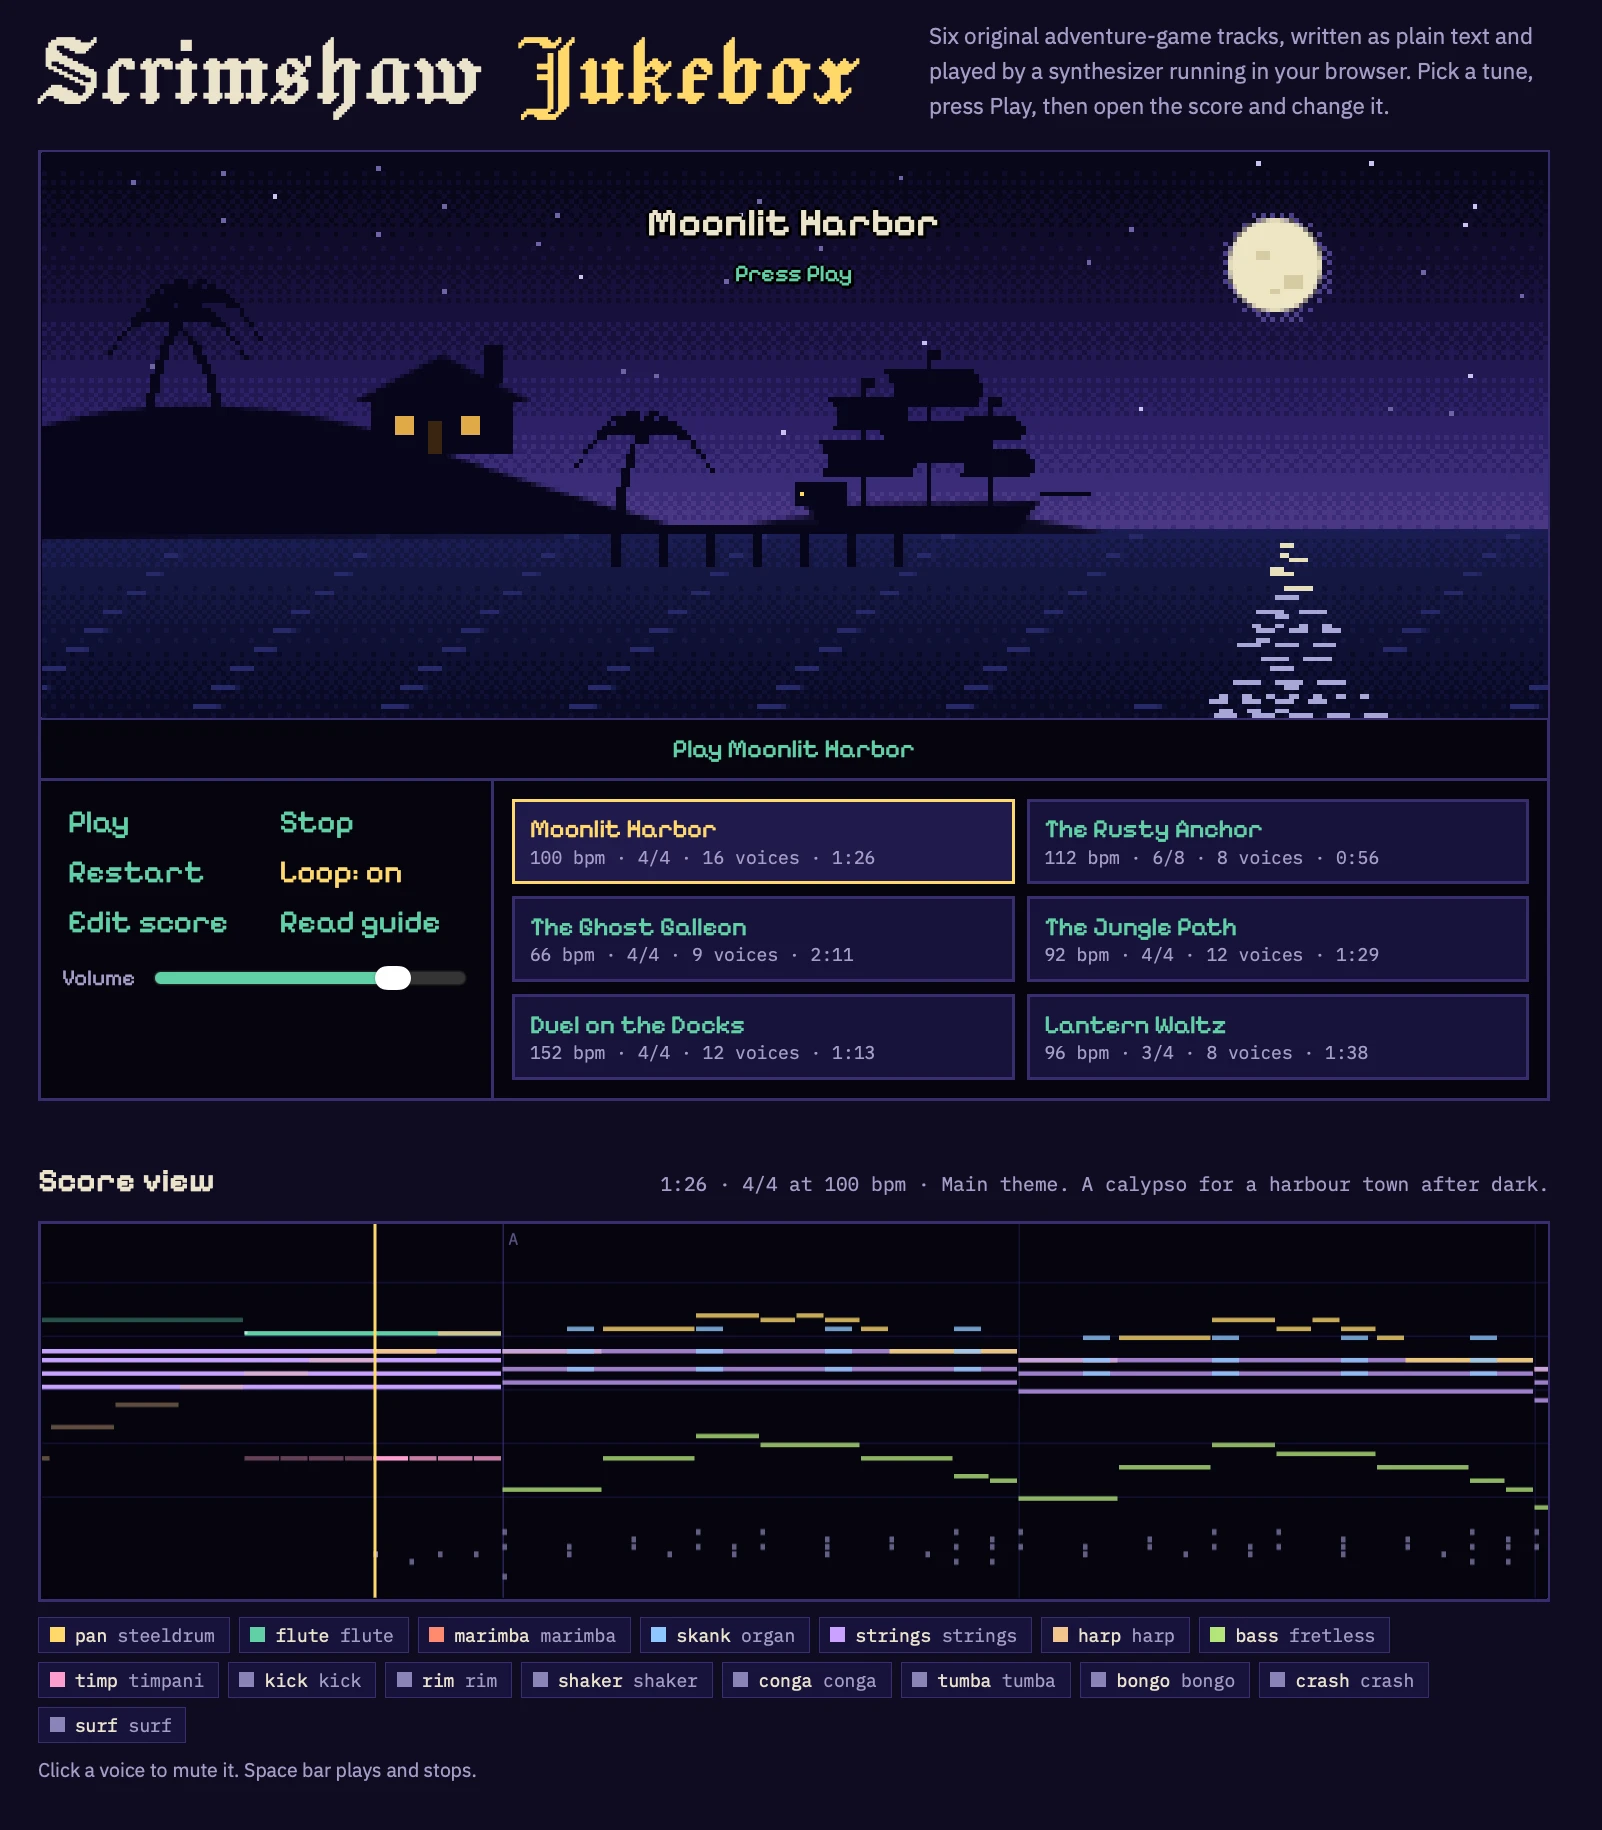
L'interfaccia di Scrimshaw Jukebox. Il brano visualizzato, «Moonlit Harbor», è descritto come «un calypso per una cittadina portuale a notte fonda», a 16 voci e 100 bpm. Screenshot: Simon Willison.
I sei brani spaziano tra metri e velocità molto differenti: «Moonlit Harbor» è un 4/4 a 100 bpm, «The Rusty Anchor» viaggia in 6/8, «The Ghost Galleon» scende a un andamento lento di 66 bpm, «Duel on the Docks» schizza a 152 bpm e «Lantern Waltz» è impostato in 3/4.
In fondo alla pagina Willison ha inserito anche un prompt pronto all'uso per insegnare questa sintassi a qualsiasi LLM. C'è però un'avvertenza cruciale: «l'errore più comune è una battuta con il numero errato di step, quindi conta ogni battuta». L'editor integrato segnala subito i mismatch metrici, permettendo di rimandare gli errori in pasto al modello per la correzione. Il flusso compositivo si trasforma così in un ciclo di compilazione e debug, identico allo sviluppo software assistito da AI.
Perché la notazione testuale funziona così bene con gli LLM
Lavorare sulla partitura anziché generare forme d'onda audio non è una novità assoluta. Nel febbraio 2024 un gruppo di ricerca composto da 35 autori ha presentato ChatMusician: partendo da LLaMA2, il modello era stato sottoposto a pre-training continuato e fine-tuning sulla notazione ABC, uno standard testuale consolidato per scrivere musica. L'idea di fondo era trattare la musica come una seconda lingua. I ricercatori avevano dimostrato che il modello era in grado di comporre brani completi e ben strutturati, superando la baseline di GPT-4 senza compromettere le abilità linguistiche generali.
Scrimshaw poggia su una logica simile, ma con una differenza sostanziale. ChatMusician richiedeva dataset dedicati e una fase di addestramento mirato; qui, invece, un modello generico ha progettato una sintassi da zero su richiesta, ha programmato il sintetizzatore per riprodurla e ha composto i brani all'interno di un'unica sessione di chat. La mia interpretazione — che resta un'ipotesi logica e non un dato misurato — è che il modello stia eccellendo soprattutto sul piano del software design: sceglie una rappresentazione in cui il ritmo è semplice aritmetica e la progressione strutturale è visibile direttamente nel testo.
Questo approccio richiama da vicino le origini a cui si ispira. Nel 1990 le musiche di Monkey Island non erano tracce audio registrate: erano sequenze di istruzioni MIDI elaborate dall'hardware sonoro presente sul PC dell'utente. Come ricorda la ricostruzione storica di The International House of Mojo, il compositore Michael Land trovò impossibile sincronizzare a dovere la musica con le azioni di gioco nel primo capitolo. Coinvolse quindi Peter McConnell per sviluppare insieme il sistema interattivo iMUSE su Monkey Island 2. La scelta di Scrimshaw di separare una intro una tantum da un loop continuo richiama direttamente quella tradizione di musica concepita come puro codice esecutivo.
Siamo davanti a una nuova capacità emergente?
Willison si domanda se questa abilità compositiva non sia assimilabile a quanto avvenuto di recente con la grafica 3D: una competenza emersa nei modelli linguistici solo negli ultimi mesi. Il parallelo trova riscontro in altri esperimenti pubblicati sul suo blog. A settembre 2026 raccontava come GPT-6 Astra, eseguito tramite Codex, avesse impiegato 17 minuti e 51 secondi per ricreare in Blender un uovo in stile Fabergé partendo da una singola immagine. A novembre 2025, invece, un test analogo su POV-Ray per generare un pellicano in bicicletta si era concluso con la maggior parte dei modelli incapace persino di produrre uno script privo di errori di sintassi.
I dati a disposizione suggeriscono tuttavia cautela prima di affermare che «i modelli ora sanno comporre»:
- La composizione simbolica tramite LLM non nasce oggi. ChatMusician lo faceva già nel 2024, pur appoggiandosi a un fine-tuning specialistico.
- Il vero salto potrebbe essere l'autonomia. Un modello generico è riuscito, senza addestramento ad hoc, a creare un formato funzionale, un sintetizzatore operativo e composizioni stilisticamente coerenti. Resta da verificare se i modelli delle generazioni precedenti ne sarebbero stati capaci: è proprio il dubbio sollevato da Willison, che auspica test comparativi approfonditi con architetture passate e presenti.
Limiti tecnici e ragioni per mantenere i piedi per terra
Un singolo prompt e un solo paio d'orecchie. Giudicare un risultato «sorprendentemente buono» è una reazione soggettiva, non una metrica scientifica. Non esistono benchmark pubblici pensati per valutare la composizione simbolica text-to-score. Le classifiche più note, come AA-Music-Instrumental e AA-Music-Vocal v1.1 di Artificial Analysis, misurano i generatori audio tramite votazioni alla cieca a coppie con giurie dedicate. Non sono calibrate per giudicare un modello testuale che scrive codice per sintetizzatori.
La tendenza a ricalcare lo stile. Alla richiesta di replicare il livello qualitativo di Monkey Island, Claude si è appiattito sul suo immaginario: pirati, taverne, calypso e navi fantasma. Trattandosi di un progetto dimostrativo con melodie originali, non ci sono tracce di plagio diretto dei temi storici. Tuttavia, la propensione all'imitazione tocca un nervo scoperto per l'industria musicale. Come riportato da IT Home citando il Financial Times, Sony Music ha chiesto alle piattaforme di streaming la rimozione di oltre 260.000 brani generati da AI che imitavano i propri artisti entro fine settembre, quasi il doppio rispetto ai 135.000 registrati a fine marzo. Evocare le atmosfere di un gioco non equivale a clonare la voce di un cantante, ma l'input di partenza resta lo stesso: «fammelo simile a X».
I limiti intrinseci della sintesi audio. Un sintetizzatore da browser con 65 timbri preimpostati può restituire il fascino di una scheda audio del 1990, ma siamo lontani anni luce da arrangiamento e produzione professionale. Paragonare questo output a modelli generativi audio complessi come Suno sarebbe fuorviante. Il punto di forza di Scrimshaw sta nella trasparenza: la partitura è leggera, leggibile e modificabile al volo.
Come verificare scientificamente il salto generazionale
La procedura per verificare l'ipotesi di Willison è piuttosto lineare. Basterebbe somministrare il prompt originale di Scrimshaw a modelli di diverse generazioni senza modifiche, delegando all'editor il conteggio delle battute non valide a livello di sintassi. I brani corretti potrebbero poi essere sottoposti a un ascolto alla cieca con confronti a coppie, replicando la metodologia di Artificial Analysis per l'audio. Se i modelli più vecchi dovessero produrre partiture formalmente corrette ma prive di coerenza tematica, mentre le versioni recenti dimostrassero una solida gestione delle strutture musicali, l'intuizione di Willison troverebbe conferma. In caso contrario, il merito andrebbe attribuito soprattutto all'ingegnosità del formato e del tooling, non a un balzo evolutivo nell'orecchio musicale delle AI.
Fino ad allora, Scrimshaw Jukebox resta l'esempio tangibile di come la composizione musicale possa essere affrontata alla stregua della programmazione: testo semplice in ingresso, musica in uscita e bug da correggere riga per riga.
Fonti
- Articolo originale: Simon Willison, «Tool: Scrimshaw Jukebox», 6 ottobre 2026
- Tool Scrimshaw Jukebox e guida al formato della partitura
- La conversazione condivisa con Claude da Willison
- Ruibin Yuan et al., «ChatMusician: Understanding and Generating Music Intrinsically with LLM», arXiv 2402.16153, febbraio 2024
- The International House of Mojo, «LucasArts' Secret History #6: The Music of LeChuck's Revenge»
- Simon Willison, post con tag «3d» (esperimento Blender/GPT-6 Astra, 9 settembre 2026; test del pellicano con POV-Ray, 9 novembre 2025)
- Artificial Analysis, «Music Generation Benchmarking Methodology»
- IT Home, «Sony Music requests takedown of 260,000 AI deepfake songs» (citando il Financial Times), 6 ottobre 2026