
21 millions de morceaux aspirés : comment un simple moteur de recherche a mis l'industrie musicale face au pillage de l'IA
Mis à jour:
Fin juin 2026, la star américaine SZA lâchait une capture d'écran cinglante en story Instagram : « Je viens de vérifier. L'IA a été entraînée sur 238 de mes morceaux. Dont certains, j'en suis sûre, ne sont même jamais sortis. » Avant d'ajouter sans détour : « Si vous êtes musicien et que vous soutenez cette saloperie dégénérée ? Vous me DÉGOÛTEZ et RIEN de ce que vous pourrez dire ne rendra ça acceptable. » (Rolling Stone)
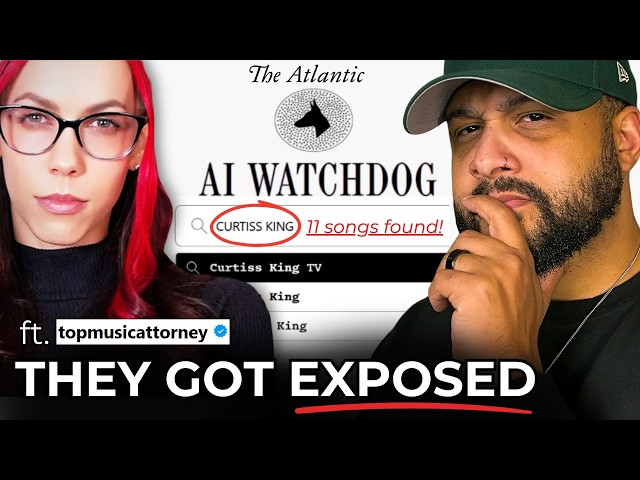
Si l'artiste a pu faire cette vérification en quelques clics, c'est grâce au projet AI Watchdog piloté par Alex Reisner pour The Atlantic. Ce mois-là, le média américain a élargi ses investigations — jusqu'alors concentrées sur les livres, les articles scientifiques et la vidéo — au monde de la musique. En rendant publics plusieurs jeux de données massifs utilisés par les développeurs d'IA et en les intégrant à un moteur de recherche ouvert, le site a provoqué un véritable séisme. Des sociétés d'auteurs aux têtes d'affiche des Grammy Awards jusqu'aux musiciens de chambre totalement anonymes, tout le monde s'est mis à auditer son propre catalogue : la base recense les œuvres de plus de 250 000 artistes. La chanteuse Kehlani y a par exemple retrouvé 179 morceaux à son nom (Rolling Stone).
Pourquoi une simple barre de recherche a-t-elle eu l'effet d'une bombe ? Parce qu'elle a matérialisé une réalité que l'industrie préférait ne pas regarder en face : sans que personne ne leur demande leur avis, le travail des artistes a tout simplement été transformé en matière première brute, aspirée et exploitée à volonté par les concepteurs de modèles génératifs.
21 millions de morceaux dans la nature : la face cachée des datasets d'entraînement
Lancée en 2025, l'initiative AI Watchdog menée par The Atlantic a pour mission de remonter la trace des données utilisées pour nourrir les modèles d'intelligence artificielle. D'après les éléments de l'enquête relayés par le rapport d'origine, quatre jeux de données musicaux majeurs ont été mis au jour. Deux géants d'abord : LAION-DISCO-12M (12 millions de pistes) et Sleeping-DISCO-9M (9 millions de pistes). Puis deux bases intermédiaires de plus de 100 000 enregistrements chacune : le Spotify Tracks Dataset et le Free Music Archive Dataset. Faites le calcul : plus de 21 millions de morceaux au total.
Les investigations de Rolling Stone confirment l'ampleur du plus volumineux d'entre eux : LAION-DISCO-12M, mis en ligne en novembre 2024 par l'association allemande à but non lucratif LAION. Il rassemble plus de 12 millions de pistes siphonnées sur YouTube, accompagnées de leurs métadonnées, officiellement pour « soutenir la recherche fondamentale en apprentissage automatique sur les modèles fondationnels, la recherche d'informations musicales et l'analyse de données audio ». Le collectif est loin d'être inconnu au bataillon : c'est lui qui avait déjà constitué le jeu de données d'entraînement derrière le générateur d'images Stable Diffusion (Rolling Stone).
Sur le papier, comme le rappelle le communiqué officiel cité dans l'enquête, LAION-DISCO-12M est strictement réservé à la « recherche universitaire », tout usage commercial étant banni. Sauf que dans les faits, ce genre de clause protectrice ne pèse pas lourd face au flou juridique et à la viralité de l'open source : une fois qu'un dataset circule, son créateur n'a plus aucun contrôle sur ses réutilisations en cascade. L'autre catalogue géant, Sleeping-DISCO-9M, s'embarrasse encore moins de précautions : d'après le rapport d'origine, il puise sa matière première dans YouTube et les paroles de Genius, les développeurs ayant utilisé l'outil cloudscraper pour contourner les protections anti-scraping de Cloudflare et croiser textes, métadonnées et liens vidéo. Un jeu de données préconçu sur mesure pour les modèles génératifs audio.
Du côté du Spotify Tracks Dataset, le problème réside dans l'opacité la plus totale : ce lot de titres aspirés sur Spotify a été déposé sur la plateforme open source Hugging Face par un développeur anonyme, Spotify ayant formellement démenti toute implication. Le seul corpus à la traçabilité relativement limpide reste le Free Music Archive Dataset, compilé dès 2016 par l'EPFL (l'École polytechnique fédérale de Lausanne) à partir de la Free Music Archive. Essentiellement placé sous licences Creative Commons, il sert depuis des années d'étalon dans la recherche musicale ; Google et Stability AI ont d'ailleurs tous deux reconnu dans leur documentation technique en avoir utilisé des pans entiers.
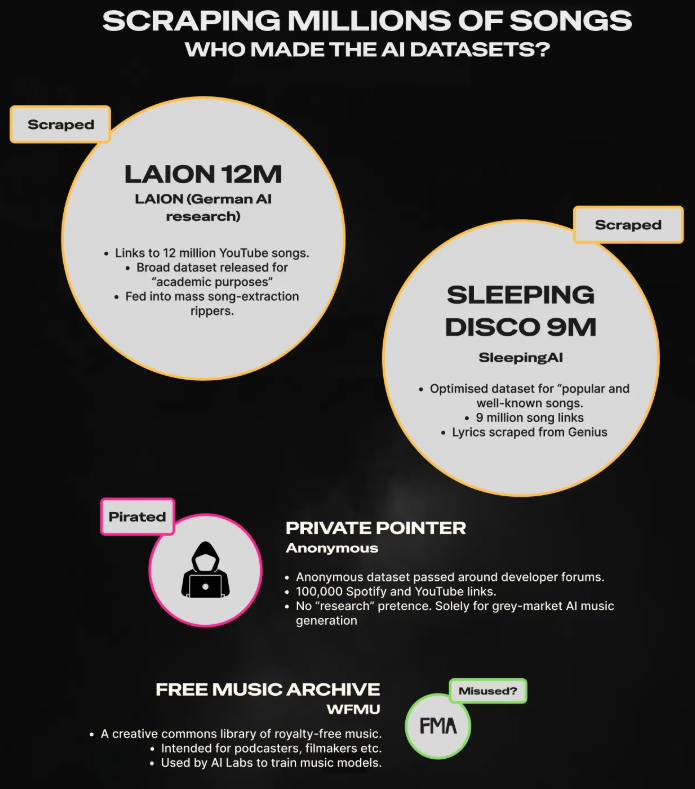
AI Watchdog tient toutefois à rappeler deux nuances essentielles : ces quatre corpus ne représentent pas l'intégralité des sources d'entraînement du marché, et la présence d'un morceau dans une base ne prouve pas formellement qu'il a effectivement servi à entraîner tel ou tel modèle. Le registre établit une « mise à disposition », pas nécessairement une « ingestion ». Mais un autre élément vient compléter le tableau : dans ses écritures judiciaires déposées en réponse à la plainte de la RIAA, Suno a elle-même admis que son modèle avait été nourri de « dizaines de millions d'enregistrements » accessibles sur le web (Rolling Stone). Entre la taille du réservoir et l'eau qui y a été bue, les deux bouts de la comptabilité finissent étrangement par se rejoindre.
Vague d'audits chez les artistes : colère noire, autodérision et scraping sauvage
Dès la première semaine de mise en ligne de l'outil, le microcosme musical mondial a oscillé entre deux sentiments extrêmes : l'indignation pure et l'humour grinçant.
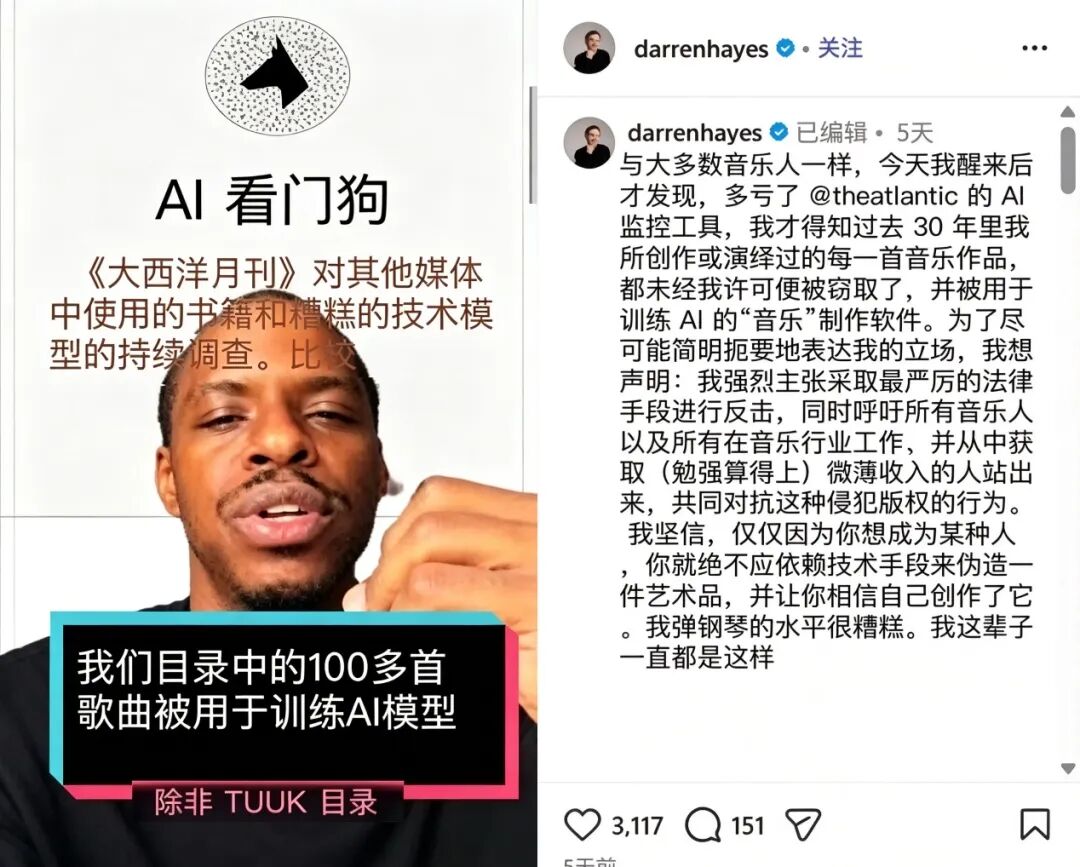
Darren Hayes, l'ancien leader de Savage Garden, a ainsi déploré que l'intégralité de ses 30 années de carrière et de création ait été purement et simplement siphonnée par des logiciels d'IA. Dean Ormston, directeur général de la société de gestion australienne APRA AMCOS et président de la CISAC (la Confédération internationale des sociétés d'auteurs et compositeurs), a accusé sans détours les entreprises d'IA de piller les répertoires de Midnight Oil, Sia, Crowded House ou encore Lorde (selon le rapport initial ; statut à la CISAC confirmé par Billboard).
SZA, elle, a choisi de cibler nommément un confrère. Après s'en être prise au célèbre producteur Diplo, l'accusant de « détenir des parts dans Suno » et de « vouloir entraîner l'outil sur les esprits noirs les plus brillants parmi les auteurs et producteurs », elle a déplacé le débat sur le terrain de la spoliation culturelle : « Nous représentons 13 % de la population américaine et nous influençons le monde entier avec nos voix et nos visions. Je n'ai pas encore entendu un seul morceau d'IA blanche… Nous n'avons aucune protection, ni sur le plan législatif, ni sur la santé, ni sur la création — nous sommes les proies les plus faciles à dépouiller. » (Variety)
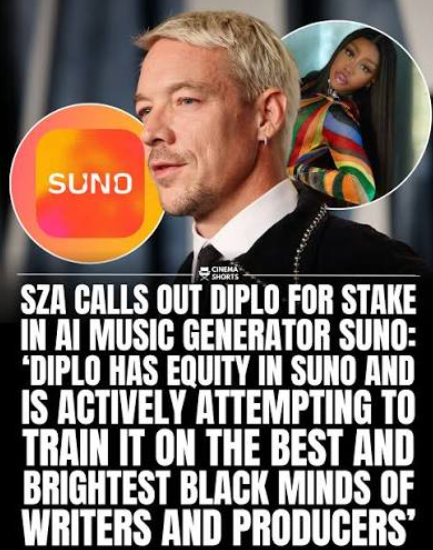
Une mise au point s'impose ici sur une rumeur persistante. Si l'article d'origine affirmait que Diplo « avait par la suite démenti posséder des parts dans Suno », les vérifications de Variety indiquent que sa participation au capital de Suno n'a jamais été formellement éclaircie ; en revanche, son investissement dans une autre startup d'IA, Aaru, est quant à lui avéré. Mais c'est surtout sa ligne de conduite qui détonne : en avril, le producteur affirmait qu'« il n'y a aucun moyen de lutter contre l'IA », expliquant qu'il n'avait plus besoin de chanteurs humains en studio car « l'IA m'offre la meilleure voix possible », avant de conseiller aux musiciens réfractaires « d'évoluer ou de capituler et devenir chauffeurs Uber, jusqu'à ce que tout le monde roule en Waymo » (Variety ; la présentation de sa prétendue « clarification » est ici rectifiée). Au même moment, Jack Brody, directeur produit de Suno, se défendait en affirmant que les métadonnées d'entraînement de la plateforme n'incluent pas les noms des artistes, que le modèle est incapable de recracher ses données sources à l'identique et que les filtres anti-usurpation d'identité sont constamment renforcés (Variety).
Le producteur Kenneth Blume, plus connu sous le nom de Kenny Beats, a quant à lui choisi des mots beaucoup plus crus. Sur X, il a lâché : « Vous êtes de vrais minables. Je n'arrive pas à concevoir qu'on puisse aller bosser chaque matin en sachant qu'on dépouille d'innombrables musiciens qui galèrent. » Avant de conclure : « Allez tous vous faire foutre, jusqu'au dernier. » (Rolling Stone)
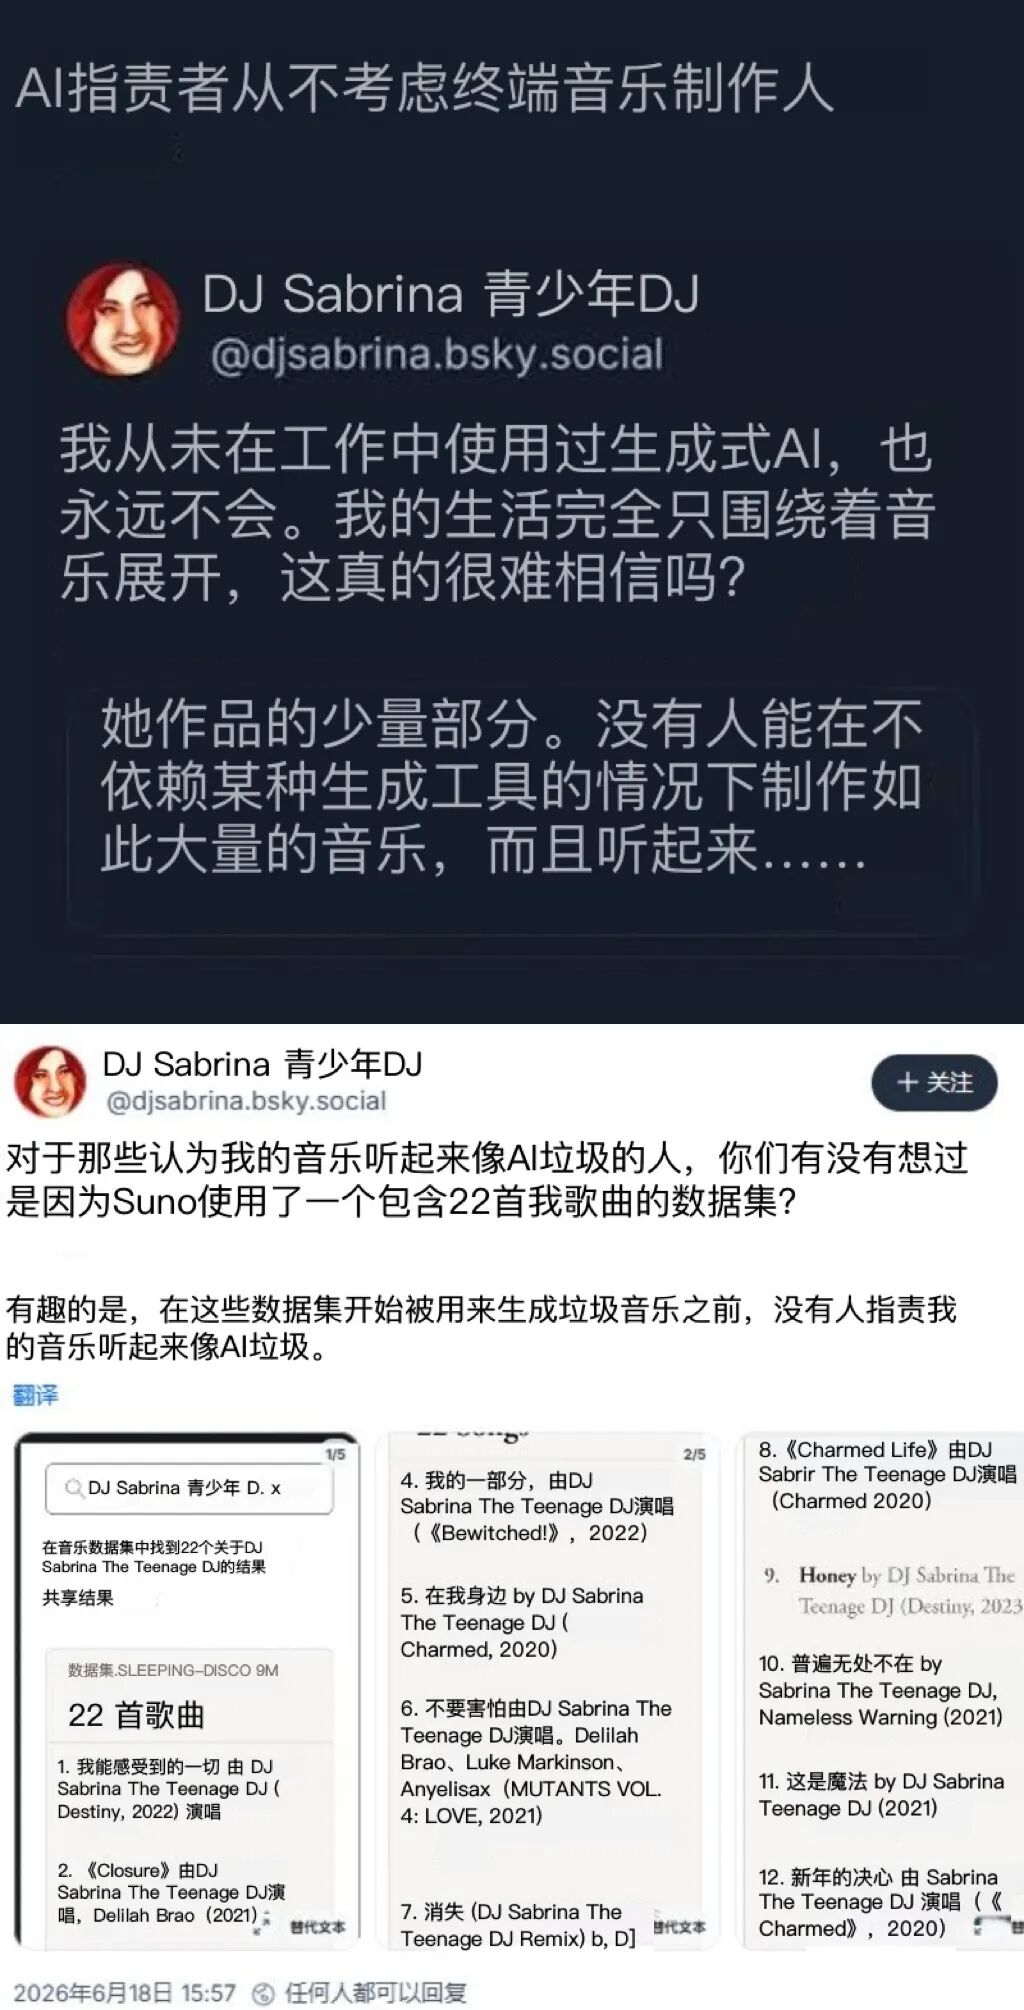
Sur la scène indépendante, l'atmosphère a viré au théâtre de l'absurde. La productrice d'électro lo-fi DJ Sabrina the Teenage DJ, découvrant 22 de ses morceaux dans la base, a résumé la situation avec ironie sur Bluesky : « Les gens qui disent que ma musique ressemble à de la bouillie d'IA se sont-ils déjà demandé si ce n'était pas simplement parce que Suno a utilisé un dataset contenant 22 de mes morceaux ? » Le chanteur de Titus Andronicus s'est fendu d'un commentaire désabusé : « Ils ont pris des faces B d'un album que personne n'a jamais écouté… grand bien leur fasse. » Tandis qu'un internaute s'étonnait sur Reddit : « J'ai trouvé mon propre morceau — alors que je suis un illustre inconnu ! » (cité par le rapport initial).
C'est précisément là que le bât blesse. Pour les mégastars, l'entraînement de l'IA représente une appropriation de valeur commerciale sans consentement ; pour les musiciens émergents ou indépendants, cela ressemble à une troublante forme de reconnaissance posthume — leur musique a enfin été écoutée, sauf que l'auditeur est un robot d'indexation. Le rapport de force se trouve ainsi totalement inversé : l'IA commence par digérer l'artiste, puis le marché juge l'artiste à l'aune des standards de l'IA. Un cadre d'une maison de distribution a même avoué à Rolling Stone s'être fait piéger par un projet généré par IA, débarquant dans l'open space en criant : « Comment ce gamin a-t-il pu passer sous nos radars ? » (Rolling Stone).
La stratégie éclatée des majors : négocier d'un côté, attaquer de l'autre
Au-delà de l'indignation morale, ce sont les mouvements capitalistiques qui dictent les règles du jeu. Et depuis plus d'un an, les trois géants de l'édition musicale ont emprunté des trajectoires radicalement divergentes.
Le coup d'envoi remonte à juin 2024 : Universal, Sony et Warner, regroupées sous la bannière de la RIAA, traînent Suno et Udio devant les tribunaux pour violation massive du droit d'auteur, les accusant d'avoir reproduit des enregistrements sans autorisation pour entraîner leurs algorithmes.
Le 29 octobre 2025, Universal Music Group est le premier à faire cavalier seul : le groupe signe un accord global avec Udio, enterrant les poursuites en échange du développement conjoint d'une plateforme d'IA musicale sous licence. Selon les termes du compromis, la nouvelle mouture d'Udio, attendue pour 2026, ne s'appuiera que sur des œuvres d'artistes UMG volontaires ; les utilisateurs pourront créer et remixer au sein d'un « jardin clos », sans pouvoir exporter leurs créations hors de l'application. Le jour même de l'annonce, Udio a coupé sans préavis la fonction de téléchargement pour ses utilisateurs, provoquant un tollé chez les abonnés payants sur Reddit ; trois jours plus tard, la plateforme cédait en ouvrant une fenêtre de sauvegarde de 48 heures (Billboard). Le 19 novembre, Warner emboîte le pas avec son propre accord transactionnel et de licence avec Udio (Billboard) ; le même jour, Suno boucle une levée de fonds de 250 millions de dollars, hissant sa valorisation à 2,45 milliards (Billboard). À la fin du mois, Warner enfonce le clou en transigeant également avec Suno : la startup s'engage à développer un nouveau modèle sur des morceaux sous licence et à débrancher l'ancien.
En clair, Warner est devenue la seule major à avoir pactisé à la fois avec Suno et Udio. Universal n'a signé qu'avec Udio et maintient ses poursuites contre Suno. Sony, de son côté, refuse tout compromis. Pendant ce temps, Udio continue d'acheter sa respectabilité : en janvier 2026, la plateforme signe un accord avec Merlin, le représentant des labels indépendants (Billboard), puis le 9 avril avec le géant de l'édition Kobalt (Billboard). Les entreprises d'IA mènent ainsi une stratégie à deux têtes : ferrailler au tribunal d'une main, et signer des chèques de licence de l'autre.
Mais ces partenariats n'ont en rien réglé la question de la rétribution des musiciens — ils ont au contraire ouvert une nouvelle ligne de front. Le 5 juin 2026, l'American Federation of Musicians (AFM), le syndicat des musiciens de studio, a assigné Universal et Warner en justice : il leur reproche d'avoir cédé des enregistrements contenant les prestations de ses membres sans la moindre rémunération, sans crédit, et en refusant même de divulguer la liste des œuvres concernées (Billboard).
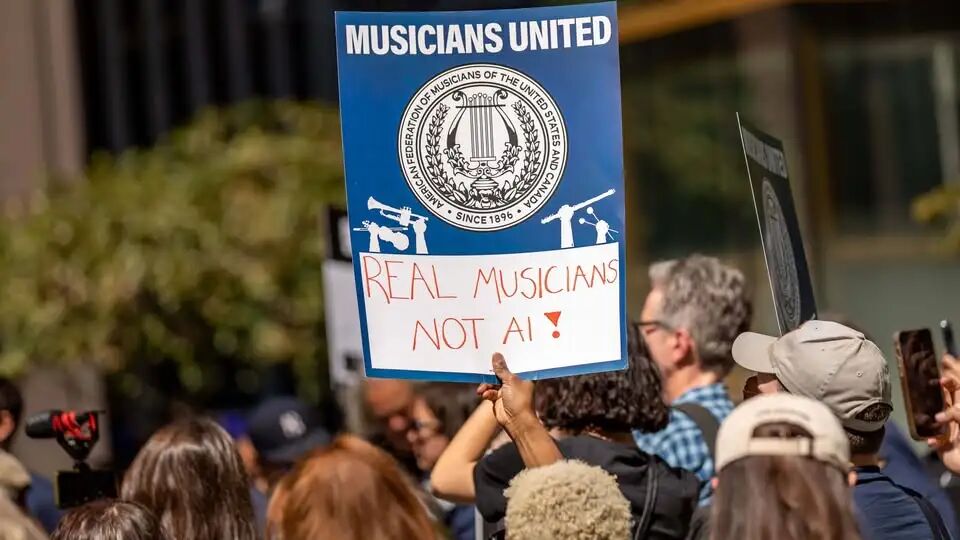
Le 22 juin, une coalition internationale de créateurs, d'auteurs-compositeurs et de managers a publié une lettre ouverte encore plus percutante : les labels et éditeurs y sont accusés « d'exiger à juste titre que les entreprises d'IA obtiennent une licence pour exploiter leurs catalogues, tout en refusant d'accorder ce même droit de regard aux artistes et compositeurs ». Nombre d'entre eux ont simplement reçu une notification précisant qu'ils étaient « inclus par défaut dans les accords, sans réelle alternative offerte » ; pire, de nouveaux contrats imposent désormais la cession des droits liés à l'IA comme condition sine qua non à la signature (Billboard). En somme, sur la question cruciale de l'autorisation, les majors se sont servies les premières sans laisser la moindre miette aux créateurs.
Jugement de Munich et « fruit de l'arbre empoisonné » : la bataille judiciaire fait rage
Si les accords signés par les majors ont pu donner l'impression, au premier semestre 2026, d'un passage « du contentieux à la négociation », une décision rendue le 31 juillet est venue rappeler que les hostilités étaient loin d'être terminées — un mois pile après la publication de l'enquête originale.
Le tribunal régional de Munich a tranché : Suno a enfreint le droit d'auteur allemand en ingérant massivement des œuvres gérées par la GEMA — notamment « Rasputin » de Boney M., « Forever Young » d'Alphaville ou « Mambo No. 5 » de Lou Bega — sans autorisation ni contrepartie financière. Le tribunal a condamné la plateforme à des dommages et intérêts (dont le montant reste à fixer, la décision étant susceptible d'appel). Il s'agit de l'un des tout premiers revers judiciaires majeurs infligés à une entreprise d'IA musicale à l'échelle internationale. La réaction de Tobias Holzmüller, directeur général de la GEMA, a été sans appel : « Le tribunal l'a dit clairement aujourd'hui : les modèles d'IA fondés sur le pillage de la propriété intellectuelle ne sont pas protégés par la loi. » Suno a répliqué en affirmant que le jugement « repose sur une mécompréhension fondamentale du fonctionnement de sa technologie » et étudie les voies de recours (Billboard).
Outre-Atlantique, le bras de fer a pris une tournure tout aussi musclée. Dès avril 2026, dans leur procédure contre Suno, Universal et Sony ont fait valoir que l'accord conclu par la startup avec Warner constituait la preuve directe d'un préjudice commercial — notion pivot de l'exception de fair use (usage loyal) : « Un marché pour ces licences existe bel et bien, et Suno en est désormais un acteur récurrent et payant. » Suno a tenté d'empêcher la communication des termes de cet accord à Universal et Sony, plaidant qu'il avait été dicté par « le risque contentieux et non par le jeu normal de la concurrence », ce qui lui ôterait toute valeur probante (Billboard).
Le 9 septembre, Suno dévoilait son modèle v6, présenté comme conçu « main dans la main avec l'industrie musicale » : données d'entraînement fournies sous licence par Warner, BMG, Believe et d'autres partenaires, partage des revenus, extinction de l'ancien modèle conformément aux engagements et restrictions sur les exports (Billboard). Dans une note interne, Robert Kyncl, PDG de Warner, a salué « une victoire stratégique », résumant sa vision autour des « trois L » : Licensing, Litigation, Legislation (licences, contentieux, régulation), à mener de front et sans compromis (Billboard).
La réplique d'Universal et Sony n'a pas tardé : neuf jours plus tard, le 18 septembre, les deux majors déposaient une nouvelle plainte conjointe contre Suno, ajoutant 61 000 titres au dossier et qualifiant sans détour le modèle v6 de « fruit du même arbre empoisonné ». Leur argument ? Au-delà des catalogues sous licence, la v6 a été entraînée sur les résultats et les interactions utilisateurs des versions antérieures (les fameuses données synthétiques), ce qui ne règle en rien le vice initial mais ne fait que « blanchir » des données illicites. La plainte retourne ainsi les propres contrats de Suno contre elle : en devenant un « acheteur régulier » sur le marché des licences, la société ne peut plus soutenir sérieusement qu'un tel marché n'existe pas (Billboard).
Une voix discordante mérite d'être soulignée : Tori Noble, juriste au sein de l'ONG de défense des libertés numériques Electronic Frontier Foundation (EFF), rejoint la position de Suno sur ce terrain. Selon elle, la jurisprudence Meta « constitue sans doute l'approche la plus rigoureuse en droit » — « sans quoi le titulaire de droits pourrait fabriquer de toutes pièces un marché de licences sur des usages qu'il n'a pas le droit de monétiser… un peu comme si quelqu'un installait des barrières autour d'un parc public pour en faire payer l'entrée ». D'ailleurs, dans le contentieux opposant des auteurs de livres à Anthropic, au moins un juge fédéral américain a déjà estimé que l'entraînement d'IA relevait du fair use (Billboard). Aux États-Unis, la question de savoir si l'entraînement d'une IA constitue un usage loyal reste donc entièrement ouverte — et c'est sur cette incertitude que chacun mise des millions.
Refonder le modèle économique : des « droits d'entraînement » aux technologies d'attribution
Si les batailles judiciaires soldent le passé, c'est l'architecture des flux financiers qui façonnera l'avenir. À mesure que les données d'entraînement se muent en actif commercial à part entière, l'industrie est obligée de réinventer ses règles de répartition.
L'enjeu financier donne le vertige : d'après les projections du cabinet Global Info Research citées dans le rapport initial, le marché mondial des jeux de données d'entraînement pour l'IA pesait environ 1,847 milliard de dollars en 2025 et devrait atteindre 11,458 milliards d'ici 2032, soit une croissance annuelle moyenne de 29,7 % ; une autre étude avance même le chiffre de 23,18 milliards à l'horizon 2034 (des données à manier avec précaution, n'ayant pu être recoupées de manière indépendante). Mais la tendance est unanime : la donnée s'impose comme la ressource la plus stratégique de l'ère algorithmique.
Le casse-tête comptable est le suivant : le droit d'auteur traditionnel fonctionne sur le principe « une diffusion = une redevance », alors que l'entraînement d'une IA consiste à assimiler une œuvre une seule fois pour en distiller l'essence dans une infinité de productions futures. Il faut donc inventer un modèle de rémunération à plusieurs étages — et les premiers jalons sont déjà posés.
La STIM, la société de gestion collective suédoise citée dans l'enquête, a dégainé la première copie le 9 septembre 2026 : elle a signé la toute première licence collective d'IA musicale avec la startup Songfox et la société spécialisée dans les technologies d'attribution Sureel. Comme le détaille Billboard, le contrat ventile la rémunération en trois volets : un versement forfaitaire initial pour la phase d'entraînement, un intéressement sur le chiffre d'affaires global de l'éditeur d'IA, et une commission supplémentaire sur les revenus générés par les morceaux créés à partir des œuvres du catalogue. Chaque œuvre doit faire l'objet d'un accord exprès de son auteur, la répartition s'effectue à parts égales (50/50) entre composition et enregistrement, et les outils d'attribution de Sureel se chargent de tracer les flux. La direction de la STIM a qualifié ce cadre de « modèle de référence », traçant un parallèle avec la transition vers le streaming : « Poursuivre ceux qui volent, tout en fournissant une voie claire pour opérer en toute légalité » (Billboard).
Ce schéma ne sort pas de nulle part : l'industrie et les chercheurs balisaient le terrain depuis des mois. D'après l'article source, une publication menée par les équipes de Sony AI en octobre 2025, intitulée Attribution-by-design, préconisait déjà de distinguer l'attribution au moment de l'entraînement de celle réalisée lors de l'inférence, afin de mettre en place une traçabilité vérifiable et une clé de répartition équitable. Plus tôt encore, les travaux sur le « droit d'auteur computationnel » de l'Université de l'Illinois à Urbana-Champaign proposaient de calquer le système sur les modèles de Spotify ou YouTube : déterminer par des algorithmes d'attribution quelles œuvres d'origine ont influencé un morceau généré, pour reverser les royalties en conséquence (détails repris de l'enquête originale). L'intégration d'une entreprise d'attribution dans l'accord de la STIM prouve que ces concepts académiques sont en train de devenir des clauses contractuelles bien réelles.
En amont, le tournant est déjà visible dans les contrats d'enregistrement. Les révélations de Billboard indiquent que plusieurs labels et éditeurs ont discrètement intégré des clauses d'entraînement IA dans leurs nouveaux contrats — le label de musique électronique B1 Recordings (filiale de Sony) s'octroie même des « droits exclusifs et illimités » d'exploiter les enregistrements « dans des modèles et systèmes d'intelligence artificielle générative… y compris pour leur entraînement ». Les plus éminents juristes du secteur alertent sur le fait que certaines maisons de disques pourraient s'appuyer sur d'anciennes clauses de cession globale (initialement pensées pour TikTok ou Instagram) pour alimenter les datasets sans demander l'accord individuel des musiciens (Billboard). La nouvelle comptabilité s'écrit donc aux deux bouts de la chaîne : d'un côté, l'argent frais versé par les entreprises d'IA aux maisons de disques ; de l'autre, la révision des contrats historiques entre les labels et leurs artistes.
L'ampleur du manque à gagner : l'avertissement chiffré de la CISAC
Que risquent concrètement de perdre les créateurs ? L'évaluation la plus documentée émane d'une étude commandée par la CISAC au cabinet de conseil en stratégie PMP (publiée en novembre 2024) : d'ici 2028, l'IA générative pourrait amputer les revenus des auteurs et ayants droit d'environ 4 milliards d'euros par an — soit 24 % des montants perçus via les organismes de gestion collective. À cette même échéance, le marché de la musique générée par IA pèserait quant à lui 16 milliards de dollars (Billboard). Björn Ulvaeus, président de la CISAC et membre fondateur d'ABBA, l'a formulé sans fard lors de la présentation du rapport : « Le succès de l'IA ne repose pas sur des contenus du domaine public, mais sur des œuvres protégées. Nous devons négocier un accord équitable. »
La même étude, relayée par le rapport d'origine, esquisse des bouleversements structurels profonds : en 2028, la musique générée par IA devrait représenter 20 % des revenus des plateformes de streaming et 60 % de ceux de la musique de stock (les catalogues d'illustration sonore). Les premières victimes ne seront sans doute pas les grands albums de stars, mais la manne discrète des musiques d'ambiance — celles diffusées dans les restaurants, les commerces ou les productions audiovisuelles à petit budget. Une chronique de Billboard tirait déjà la sonnette d'alarme : c'est précisément cette musique fonctionnelle qui fait vivre un bataillon entier d'instrumentistes — « si ce gagne-pain disparaît, ces musiciens auront-ils encore les moyens de payer leurs heures de studio ? » (Billboard).
Le constat le plus glaçant de l'étude tient en une phrase : « À cadre réglementaire inchangé, les créateurs ne tireront aucun bénéfice de la révolution de l'IA générative. » La menace est double : un manque à gagner immédiat dû à l'utilisation non consentie de leurs œuvres pour l'entraînement, couplé à une éviction progressive de leurs revenus traditionnels par des productions synthétiques. Voilà pourquoi la colère de SZA renvoie, au fond, à trois questions implacables : qui a donné l'autorisation ? Qui encaisse les bénéfices ? Et si une chanson est devenue une composante intrinsèque des capacités d'un modèle d'IA, pourquoi son auteur reste-t-il totalement exclu du partage de la valeur ?
Le nouveau cadre légal se dessine dans les détails
La protection du style artistique constitue l'autre grand front de cette refonte générale. Aux États-Unis, des jalons ont déjà été posés : l'ELVIS Act promulgué au Tennessee en 2024 protège la voix des artistes contre l'usurpation par IA (Billboard), tandis que le projet de loi fédéral NO FAKES Act poursuit son cheminement au Congrès (Billboard). D'après le rapport initial, des parlementaires américains ont également déposé en juin 2026 le CREATOR Act en faveur des artistes visuels, leur conférant le droit de s'opposer et de réclamer réparation lorsque l'IA reproduit commercialement leur patte graphique sans autorisation — le droit d'auteur actuel protégeant les œuvres tangibles, non les styles (aucune couverture anglophone indépendante de ce texte n'ayant pu être vérifiée, ces détails sont rapportés ici sous réserve). Si ces initiatives sont encore balbutiantes, l'orientation est claire : faire passer la protection du « style » du statut de débat théorique à celui de norme juridique.
Les plateformes de streaming prennent elles aussi leurs dispositions. Le 29 juin, TIDAL a annoncé qu'elle identifierait et marquerait les morceaux reconnus comme quasi intégralement générés par IA : les titres signalés restent écoutables, mais sont privés de toute monétisation ; Spotify et Apple Music ont déployé des outils de détection similaires (Rolling Stone). Et la musique synthétique ne se cantonne plus à de pâles imitations expérimentales : le titre « Let Me Be », finalisé grâce à Suno, s'est hissé pendant six semaines en tête du classement Afrobeats américain de Billboard, tandis que l'artiste virtuelle Xania Monet s'est vu proposer un contrat d'enregistrement de 3 millions de dollars — suscitant un commentaire sans appel de Kehlani : « Je ne respecte pas ça » (Billboard).
Mettez bout à bout tous les événements de 2026 : le tribunal de Munich a créé un premier précédent établissant que l'usage non autorisé constitue une contrefaçon ; Universal et Sony ont démontré par une nouvelle plainte qu'une transaction ne blanchissait pas l'ensemble des procédés — la v6 n'étant pas tirée d'affaire ; la doctrine des « trois L » de Warner prouve que licences, procès et lobbying peuvent marcher de concert ; la STIM a posé la première brique d'un contrat collectif intégrant entraînement, abonnements et flux de sortie ; tandis que le syndicat AFM et les collectifs d'auteurs rappellent à l'ordre une industrie où l'argent frais n'a pas encore ruisselé jusqu'aux créateurs.
Tout ceci renvoie au nœud fondamental du dossier : le débat ne porte plus sur l'opportunité de réagir, mais sur la manière d'évaluer la valeur et d'en organiser la répartition. La véritable bataille ne se jouera pas sous les projecteurs des prétoires, mais dans la mécanique minutieuse de l'entraînement, de l'inférence, de la traçabilité et des clés de reversement. Ce qui s'écrit sous nos yeux, ce n'est pas seulement une jurisprudence sur le droit d'auteur, c'est l'ensemble du grand livre comptable de l'industrie musicale à l'ère de l'intelligence artificielle — et chaque ligne fait aujourd'hui l'objet d'une lutte acharnée.
Sources
- 音乐先声 (Music First Sound): 《音乐圈版权保卫战:AI是如何洗劫音乐人的?》 (article d'origine, en chinois)
- Rolling Stone: Have Artists Reached Their Breaking Point With AI?
- Variety: SZA Slams 'Disgusting' Musicians Using AI, Says Platforms Like Suno Train on the 'Best and Brightest Black Minds of Writers and Producers'
- Billboard: UMG-Udio Deal FAQ: What Questions Remain About the AI Agreement That's Shaken Up the Music Biz?
- Billboard: Warner Music Settles With Udio, Signs Deal for Licensed AI Music Platform
- Billboard: Udio Strikes AI Licensing Deal With Merlin for Independent Labels
- Billboard: Udio and Kobalt Ink Partnership
- Billboard: Musicians Union Sues UMG, WMG Over AI Settlements: 'Refused to Provide Compensation'
- Billboard: Musicians Pen Letter, Warning About AI Music Deals: 'Innovation Cannot Be Used to Override Artists' Rights'
- Billboard: Suno Held Liable for Infringing German Song Copyrights in Landmark Court Ruling
- Billboard: Danish Rights Group Koda Sues Suno for 'Biggest Theft in Music History'
- Billboard: Licenses Versus Lawsuits: Why Suno's Parallel Legal Strategies May Pose a 'Conundrum'
- Billboard: UMG & Sony Hit Suno With New Lawsuit After Label-Backed Model: 'Fruit of the Same Poisoned Tree'
- Billboard: Suno Launches First AI Music Models 'in Partnership With the Music Industry'
- Billboard: Warner Music Group CEO Pens Memo About Suno Partnership: 'This Is a Smart Win'
- Billboard: As Some Labels Strike Deals With Suno, Artist Reps Sound Off: 'It's the Wild, Wild West'
- Billboard: STIM Explores AI Music Licensing Framework With Songfox Deal: 'This Is a Blueprint'
- Billboard: Will Generative AI Become a Creator Terminator?
- Billboard: CISAC Elects APRA AMCOS CEO Dean Ormston as New Chair
- Billboard: Tennessee Adopts ELVIS Act, Protecting Artists' Voices From AI Impersonation
- Billboard: NO FAKES Act Returns to Congress With Support From YouTube, OpenAI for AI Deepfake Bill
- Billboard: Kehlani Slams AI Artist Xania Monet Over $3 Million Record Deal Offer: 'I Don't Respect It'