Música en texto plano: qué revela la gramola pirata de Claude sobre la composición con LLM
Actualizado:
Basta abrir una pestaña del navegador para escuchar seis temas instrumentales que parecen salidos de una aventura gráfica de los noventa. No hay archivos de audio grabados ni librerías de samples: cada canción se reduce a un archivo de texto plano interpretado al vuelo, nota por nota, por un sintetizador en Web Audio. Y lo más llamativo es que un modelo de lenguaje se encargó de escribir tanto la música como el propio motor de sonido.
La idea es del desarrollador Simon Willison. El 6 de octubre de 2026 le planteó tres retos a Claude Opus 5.5: idear un formato de texto minimalista para componer música de videojuegos, programar un reproductor web capaz de interpretarlo y generar varias canciones de muestra. El listón de referencia que fijó fue muy concreto: la banda sonora del primer The Secret of Monkey Island. De ahí nació Scrimshaw Jukebox. El propio Willison reconoció que el resultado se volcó en la ambientación pirata «mucho más de lo previsto», pero calificó las piezas de «sorprendentemente buenas».
Una simple demo no demuestra una revolución técnica, algo que Willison tampoco pretende insinuar. Sin embargo, la arquitectura del proyecto ofrece pistas muy valiosas sobre cómo procesan la música los modelos de lenguaje y qué incógnitas quedan todavía por despejar.
Cómo funciona la notación inventada por Claude
El núcleo de este experimento está en el diseño del formato, detallado al completo en la web de la herramienta.
- El ritmo se basa en conteos. Cada compás se divide en un número idéntico de pasos. Una nota como
D5dura un paso; cada guion consecutivo suma otro más (de modo queD5---dura cuatro pasos) y cada punto representa un paso de silencio. - La métrica son dos cifras. Definir
beats 4ysteps 4genera un compás de 4/4 en semicorcheas;beats 2ysteps 3da lugar a una giga en 6/8, mientras quebeats 3consteps 2produce un vals. Mediante el parámetroswingse puede retrasar un paso sí y otro no. - Armonía con cifrado clásico. Admite acordes como
[Dm7]o[C/E], distribuyendo las notas de forma automática según el registro asignado a cada pista. - Percusión en cuadrícula. La pista de batería asigna un carácter a cada paso temporal, con patrones del estilo
x... ..x., dondexmarca un golpe youna nota fantasma. - Estructura modular clara. La partitura define patrones (bloques de compases) y utiliza una orden
playpara la introducción ylooppara el bucle continuo «al estilo de las bandas sonoras clásicas». Modificadores comoB*2duplican un bloque, mientras queA+2lo transporta un tono hacia arriba.
El reproductor incorpora 65 instrumentos sintetizados que van desde tambores metálicos y marimbas hasta clavecines, tubas, coros o percusión manual. La interfaz dibuja un piano roll interactivo en el que se puede silenciar cualquier canal, editar el código fuente de la partitura y escuchar los cambios de inmediato.
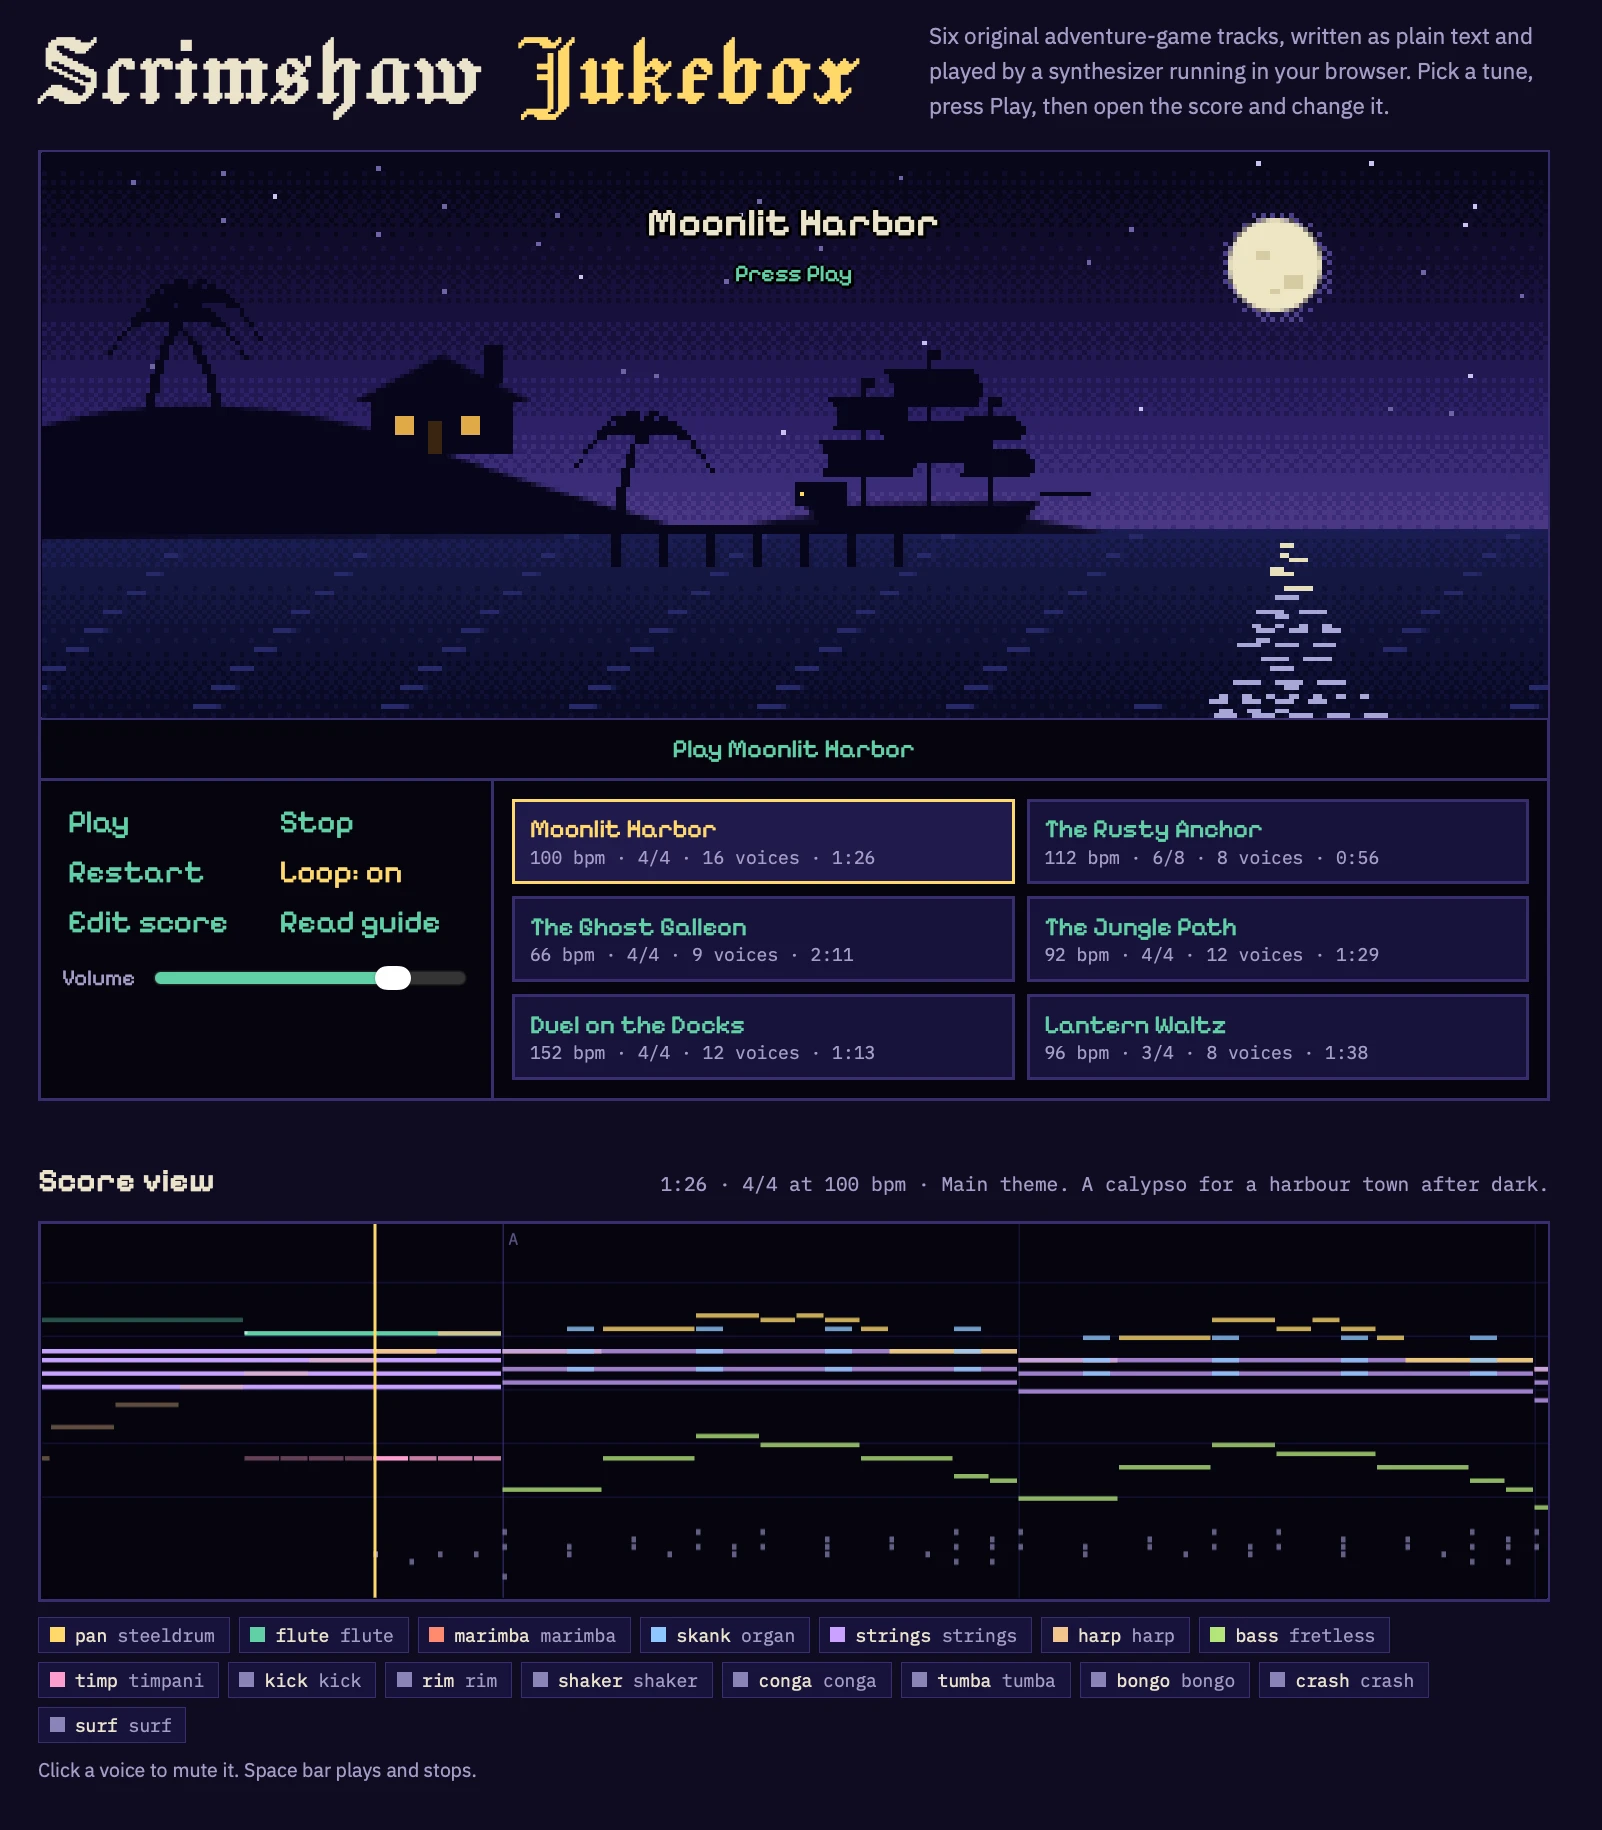
Interfaz del reproductor Scrimshaw Jukebox con la pista «Moonlit Harbor», descrita como «un calipso para un puerto al anochecer», compuesta a 16 voces y 100 bpm. Captura de pantalla: Simon Willison.
Las seis composiciones exploran métricas y tempos variados: «Moonlit Harbor» avanza a 100 bpm en 4/4; «The Rusty Anchor» adopta un 6/8; «The Ghost Galleon» arrastra un tempo lúgubre de 66 bpm; «Duel on the Docks» acelera hasta los 152 bpm y «Lantern Waltz» oscila en un clásico 3/4.
La web facilita además un prompt prediseñado para enseñar la sintaxis a cualquier modelo de lenguaje. En las instrucciones se avisa de que «el fallo más habitual es escribir compases con un recuento incorrecto de pasos, así que cuenta cada compás». Cuando las cuentas no cuadran, el editor resalta el fallo para que puedas reenviárselo al modelo y pedirle una corrección. El proceso de composición pasa a ser un ciclo de compilar y depurar, calcado al flujo de programar con un asistente de IA.
Por qué el texto plano encaja tan bien con un LLM
Tratar la música como notación en lugar de como ondas de audio no es una novedad. En febrero de 2024, un equipo de 35 investigadores presentó ChatMusician: tomaron LLaMA2 y ampliaron su preentrenamiento y ajuste fino usando notación ABC, un estándar textual clásico de partituras. En aquel proyecto definieron la música como un «segundo lenguaje» y demostraron que el modelo generaba piezas completas y bien estructuradas superiores a las de GPT-4, sin deteriorar por ello sus capacidades lingüísticas generales.
Scrimshaw comparte esa misma premisa, aunque con un matiz decisivo: si ChatMusician requirió un corpus de datos específico y un fine-tuning dedicado, aquí un modelo de propósito general creó su propia notación desde cero, programó el sintetizador para reproducirla y compuso varias canciones, todo dentro de una única conversación. A mi juicio —y esto es una interpretación, no una certeza cuantitativa—, el gran acierto de este modelo radica en el diseño de software: adoptó una representación donde el ritmo equivale a pura aritmética y la estructura musical se lee con claridad en la pantalla.
Ese planteamiento encaja a la perfección con la época que homenajea. En 1990, las bandas sonoras de Monkey Island tampoco eran pistas grabadas: consistían en instrucciones MIDI ejecutadas por la tarjeta de sonido que tuviera el usuario. Tal como recuerda la crónica histórica de The International House of Mojo, el compositor Michael Land vio imposible sincronizar la música con las acciones del jugador en la primera entrega. Tras su lanzamiento fichó a Peter McConnell y diseñaron juntos iMUSE, el célebre sistema de audio interactivo de Monkey Island 2. Al separar una introducción lineal de un bucle que se repite indefinidamente, Scrimshaw rinde homenaje directo a esa herencia de música concebida como código ejecutable.
¿Estamos ante una capacidad emergente?
Willison plantea si componer de manera solvente no será un salto «similar a lo ocurrido con los gráficos 3D»: una destreza que los modelos de texto han empezado a dominar apenas en los últimos meses. No es una comparación al azar en su blog. En septiembre de 2026 relató cómo GPT-6 Astra, ejecutándose en Codex, dedicó 17 minutos y 51 segundos a construir en Blender un modelo 3D de un huevo estilo Fabergé a partir de una única imagen generada. En cambio, en una prueba que analizó en noviembre de 2025 donde se pedía un pelícano en bicicleta en formato POV-Ray, la gran mayoría de modelos devolvía scripts que ni siquiera se podían compilar.
Con estos datos sobre la mesa, conviene matizar la idea de que «los LLM ya saben componer»:
- La composición simbólica ya existía en los modelos de lenguaje. ChatMusician lo logró en 2024, si bien recurrió a un entrenamiento especializado.
- La novedad radica en lograrlo sin entrenamiento previo. Un modelo generalista creó un formato práctico, un sintetizador funcional y temas cohesionados sin necesidad de fine-tuning. La gran incógnita —y así lo subraya Willison— es si modelos anteriores eran capaces de hacer esto mismo, algo que exigiría «experimentos rigurosos con otros modelos recientes y no tan recientes».
Límites reales y motivos para la prudencia
Una sola prueba y un único oyente no hacen estadística. Que el resultado sea «sorprendentemente bueno» es una impresión subjetiva honesta, no una métrica científica. No existe hoy un benchmark público para evaluar la composición simbólica de texto a partitura. Los rankings más consolidados en este ámbito, como los de Artificial Analysis (AA-Music-Instrumental y AA-Music-Vocal v1.1), clasifican modelos generativos de audio mediante comparaciones a ciegas por pares con un panel de evaluación; no están pensados para medir el código musical que escribe un chatbot.
El modelo cayó de lleno en la imitación estética. Al pedirle que igualase la calidad de Monkey Island, Claude lo interpretó en términos de estilo: piratas, puertos, ritmos de calipso y barcos fantasma. Aunque se trata de un experimento inofensivo con melodías originales y sin plagio directo, esta inercia no es menor en un sector musical que lidia con la clonación a gran escala. Sony Music reveló haber solicitado la retirada de más de 260.000 canciones de IA que imitaban a sus artistas antes de que terminara septiembre, casi duplicando las 135.000 registradas a finales de marzo, según cifras del Financial Times recogidas por IT Home. Replicar el género de un videojuego no equivale a clonar la voz de un artista, pero ambas peticiones arrancan con la misma orden: «haz que suene como tal cosa».
La síntesis impone un techo acústico evidente. Un sintetizador de navegador con 65 presets puede evocar con encanto una tarjeta de sonido de 1990, pero dista mucho de una orquestación o producción real. Comparar estas pistas con lo que genera un modelo de audio como Suno carece de sentido: el verdadero valor de este enfoque reside en partituras ligeras, inspeccionables y editables, no en la fidelidad sonora.
El experimento pendiente para salir de dudas
La comprobación propuesta por Willison resulta muy accesible: suministrar el prompt exacto de Scrimshaw a modelos de distintas generaciones, registrar cuántos compases fallan al parsearse y someter los temas válidos a una votación a ciegas por parejas entre oyentes, al estilo de las pruebas de Artificial Analysis. Si los modelos más antiguos generan piezas sintácticamente correctas pero sin rumbo melódico, mientras que los más recientes logran temas coherentes y bien estructurados, la sospecha de Willison ganará peso. De lo contrario, lo verdaderamente brillante habrá sido el diseño del formato y las herramientas auxiliares, no un salto mágico en musicalidad artificial.
De momento, Scrimshaw Jukebox funciona como un excelente ejemplo de la composición entendida como un problema de programación: introduces texto plano, obtienes música ejecutable y dispones de errores claros que puedes depurar.
Fuentes
- Artículo original: Simon Willison, «Tool: Scrimshaw Jukebox», 6 de octubre de 2026
- Página de la herramienta Scrimshaw Jukebox y guía del formato de partituras
- Conversación completa con Claude compartida por Willison
- Ruibin Yuan et al., «ChatMusician: Understanding and Generating Music Intrinsically with LLM», arXiv 2402.16153, febrero de 2024
- The International House of Mojo, «LucasArts' Secret History #6: The Music of LeChuck's Revenge»
- Simon Willison, artículos con la etiqueta «3d» (experimento con Blender y GPT-6 Astra, 9 de septiembre de 2026; prueba del pelícano en POV-Ray, 9 de noviembre de 2025)
- Artificial Analysis, «Music Generation Benchmarking Methodology»
- IT Home, «Sony Music requests takedown of 260,000 AI deepfake songs» (citando al Financial Times), 6 de octubre de 2026