Noten als Klartext: Was Claudes Piraten-Jukebox über LLM-Komposition verrät
Aktualisiert:
Wer im Browser gerade sechs charmante Chiptune-Stücke im Retro-Adventure-Stil hört, lauscht keinen MP3s oder Samples. Hinter den Tracks stecken reine Textdateien, die ein kleiner Web-Audio-Synthesizer Note für Note abspielt. Das Erstaunliche daran: Sowohl den Synthesizer als auch das Format und die Kompositionen selbst hat ein großes Sprachmodell geschrieben.
Das Experiment stammt vom Entwickler Simon Willison. Am 6. Oktober 2026 stellte er Claude Opus 5.5 drei Aufgaben: Entwickle ein simples Textformat für Computerspielmusik, baue einen passenden Web-Player und liefere ein paar Beispieltracks mit. Die musikalische Messlatte: der Soundtrack des Klassikers The Secret of Monkey Island. Herausgekommen ist die Scrimshaw Jukebox. Die KI habe sich zwar deutlich stärker am Monkey-Island-Thema festgebissen als ursprünglich geplant, so Willisons Fazit, das Ergebnis sei jedoch »überraschend gut« ausgefallen.
Eine einzelne Demo beweist natürlich noch keinen Durchbruch, und Willison behauptet das auch gar nicht. Die Architektur dieses Experiments zeigt jedoch sehr anschaulich, wie Textmodelle an Musik herangehen – und wo derzeit noch die offenen Fragen liegen.
Die Architektur hinter der KI-Jukebox
Der spannendste Teil des Projekts steckt im Datenformat, das auf der Projektseite detailliert dokumentiert ist.
- Rhythmus als Zählzeit: Jeder Takt ist in gleich lange Schritte (Steps) unterteilt. Eine Note wie
D5dauert genau einen Step; jeder angehängte Bindestrich verlängert sie um einen weiteren, sodassD5---vier Steps lang klingt. Ein Punkt markiert eine Pause. - Taktart über zwei Parameter:
beats 4mitsteps 4ergibt einen klassischen 4/4-Takt in Sechzehntelnoten.beats 2mitsteps 3liefert einen 6/8-Jig, währendbeats 3mitsteps 2einen Walzer erzeugt. Über einenswing-Wert lässt sich jeder zweite Step verzögern. - Akkorde beim Namen genannt: Akkordsymbole wie
[Dm7]oder[C/E]werden anhand der für die jeweilige Stimme festgelegten Tonhöhe automatisch ausgesetzt. - Schlagzeug als Step-Sequenzer: Eine Drum-Spur nutzt ein Zeichen pro Step – etwa
x... ..x., wobeixfür einen Anschlag undofür eine Ghost-Note steht. - Klare Songstruktur: Das Stück wird in Pattern (Taktblöcke) unterteilt. Eine
play-Zeile definiert das Intro, gefolgt von einerloop-Zeile für den Endlos-Loop, wie man ihn aus Spielen kennt. Befehle wieB*2wiederholen ein Pattern, währendA+2es um einen Ganzton nach oben transponiert.
Der Player bringt 65 Synthesizer-Instrumente mit – von Steel Drum und Marimba über Cembalo und Tuba bis hin zu Chorstimmen und Percussion. Die Noten werden als Piano-Roll visualisiert, einzelne Spuren lassen sich stummschalten. Praktisch: Man kann den Quelltext direkt im Browser editieren und sofort neu abspielen.
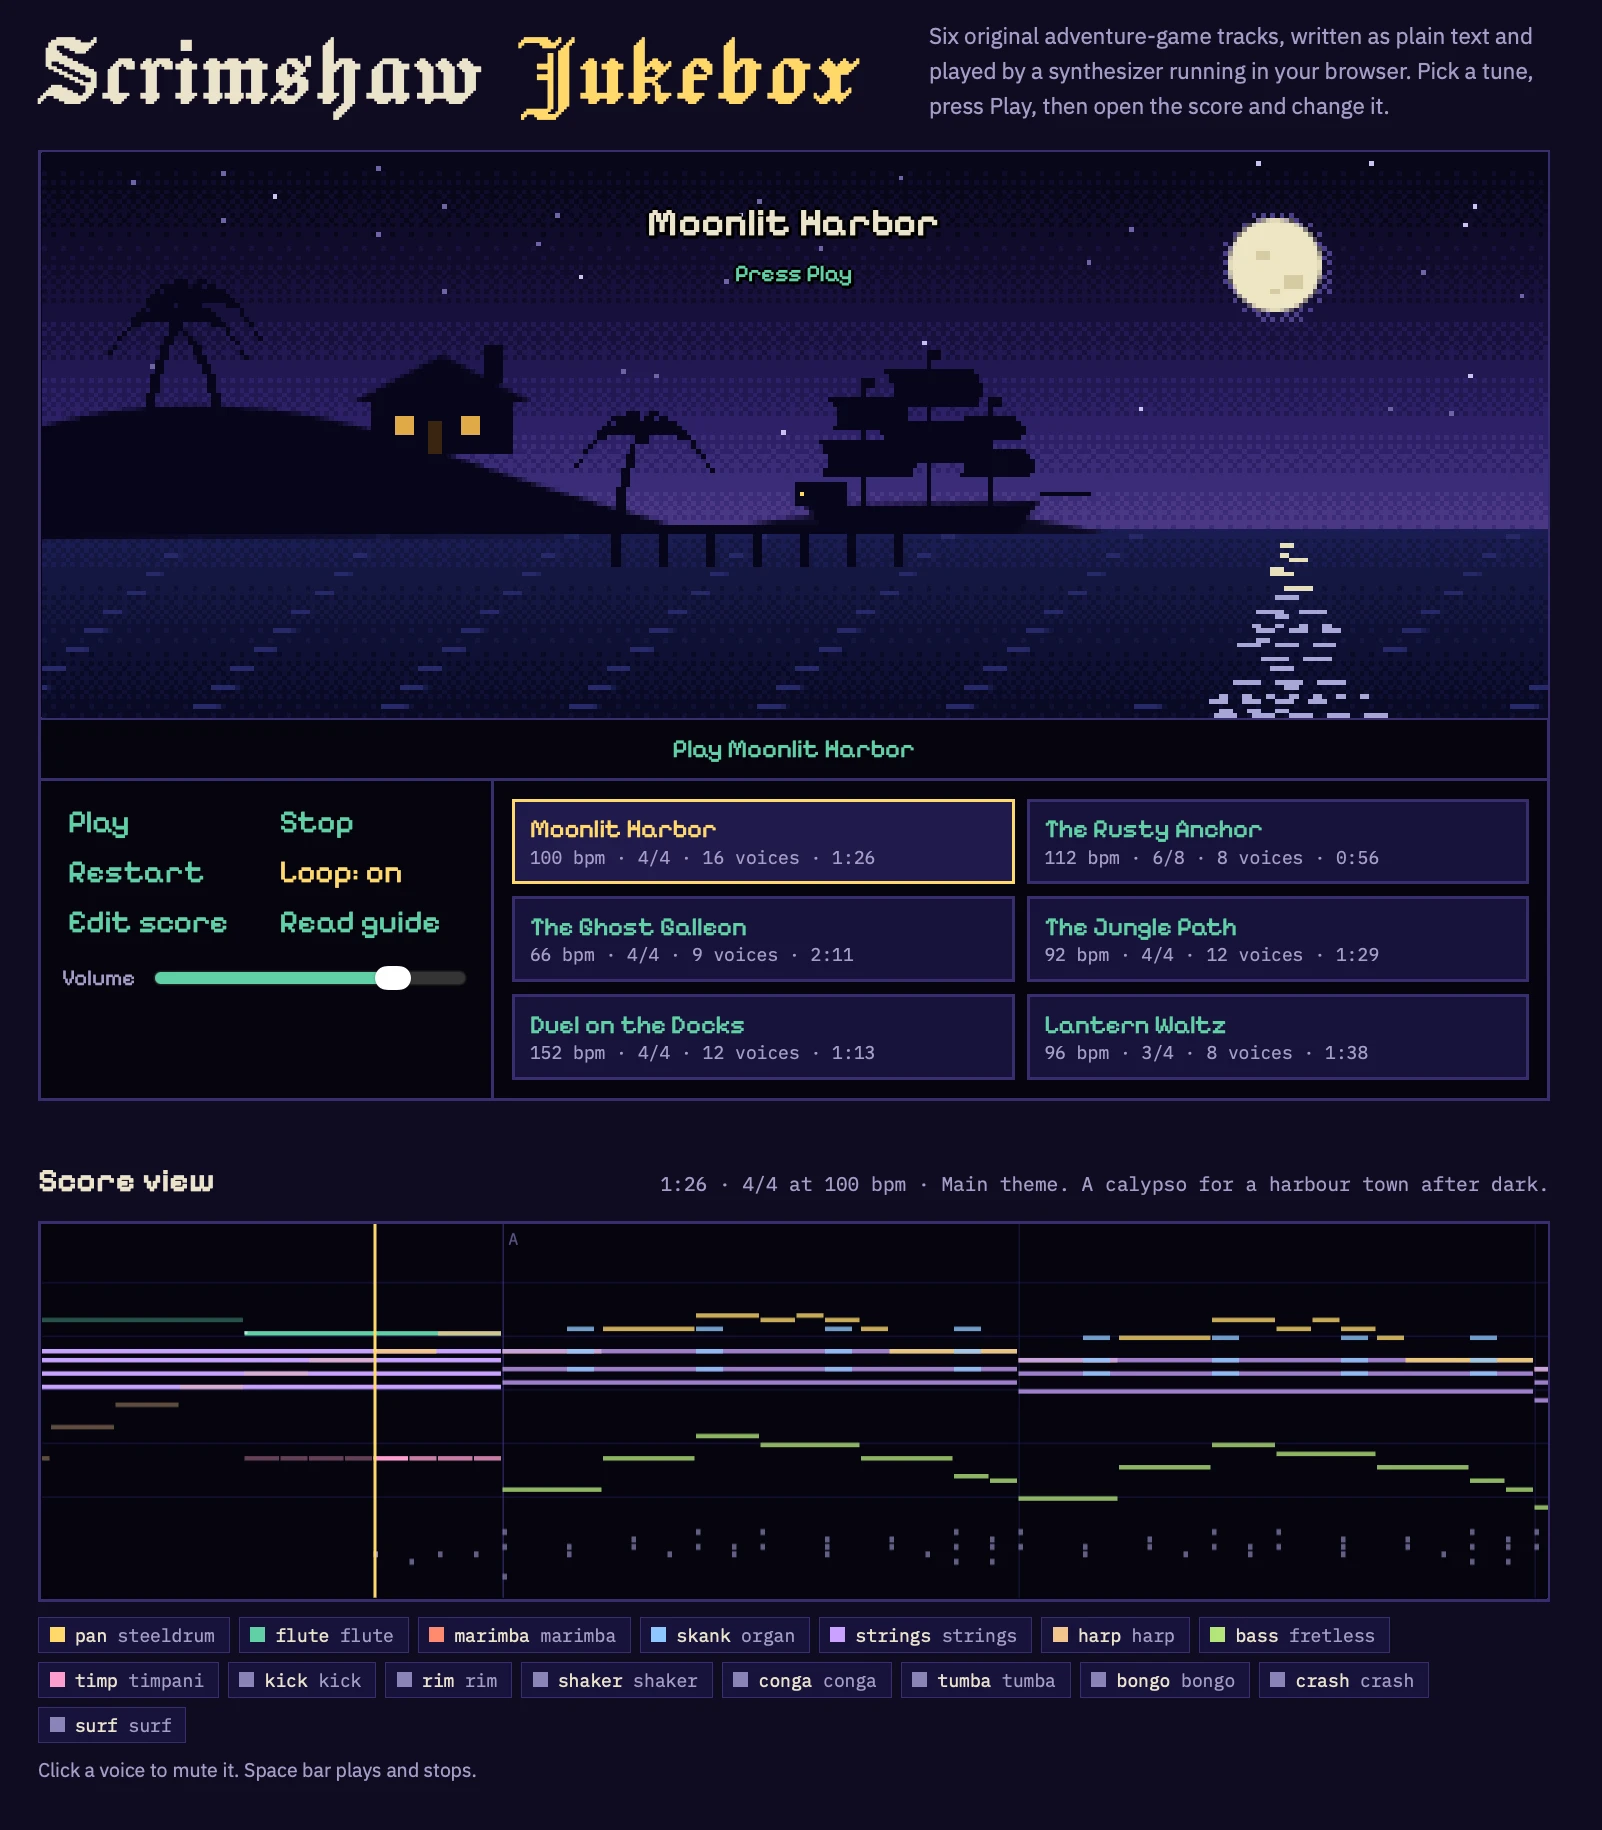
Der Player der Scrimshaw Jukebox. Der geöffnete Track »Moonlit Harbor« wird als »Calypso für eine Hafenstadt nach Einbruch der Dunkelheit« beschrieben – mit 16 Stimmen bei 100 bpm. Screenshot: Simon Willison.
Die sechs Tracks decken unterschiedliche Tempi und Taktarten ab: »Moonlit Harbor« läuft im 4/4-Takt bei 100 bpm, »The Rusty Anchor« nutzt einen 6/8-Takt, »The Ghost Galleon« schleicht mit 66 bpm dahin, »Duel on the Docks« rast mit 152 bpm und der »Lantern Waltz« setzt auf einen 3/4-Takt.
Auf der Seite stellt Willison auch einen vorgefertigten Prompt bereit, mit dem sich das Format jedem LLM beibringen lässt. Darin heißt es warnend: »Der häufigste Fehler sind Takte mit falscher Schrittanzahl – zähle also jeden Takt genau nach.« Der integrierte Editor markiert fehlerhafte Takte sofort. Man kopiert die Fehlermeldungen einfach zurück ins Prompt-Fenster – und das Modell bessert nach. Komponieren wird so zu einer Compile-and-Fix-Schleife, ganz wie beim Programmieren mit Coding-Assistenten.
Warum Textformate ideal für Sprachmodelle sind
Dass Sprachmodelle über Notationssprachen statt über rohes Audio komponieren, ist kein völlig neuer Ansatz. Bereits im Februar 2024 stellte ein 35-köpfiges Forschungsteam ChatMusician vor. Dafür wurde LLaMA2 mit ABC-Notation weitertrainiert und feingetunt – einem etablierten textbasierten Format für Partituren. Die Forscher behandelten Musik dabei ausdrücklich als »zweite Sprache«. ChatMusician erzeugte strukturierte Stücke in voller Länge, schlug eine GPT-4-Baseline und büßte durch das Musiktraining nichts von seinen allgemeinen Sprachfähigkeiten ein.
Scrimshaw folgt demselben Prinzip, geht aber einen entscheidenden Schritt weiter: Während ChatMusician ein dediziertes Trainingskorpus und Fine-Tuning brauchte, entwarf hier ein universelles Modell das Notationsformat, schrieb den Interpreter und komponierte die Stücke – alles ad hoc innerhalb eines einzigen Chat-Dialogs. Das legt nahe: Ein großer Teil dessen, was ein generalistisches LLM hier leistet, ist letztlich sauberes Software-Design. Das Modell wählt eine Abstraktionsebene, auf der Rhythmus reine Arithmetik ist und musikalische Strukturen als Text logisch greifbar werden.
Dieser Ansatz erinnert frappierend an die historischen Vorbilder: Auch die Original-Soundtracks von Monkey Island aus dem Jahr 1990 bestanden nicht aus Audioaufnahmen. Es waren reine MIDI-Befehle, die von der jeweiligen Soundkarte des Spielers interpretiert wurden. Wie The International House of Mojo in seiner Serie über LucasArts beschreibt, scheiterte Komponist Michael Land beim ersten Teil noch daran, Musik und Gameplay sauber synchron zu halten. Für Monkey Island 2 holte er Peter McConnell an Bord, und gemeinsam entwickelten sie das interaktive Musiksystem iMUSE. Scrimshaws Trennung zwischen einmaligem Intro und Wiederholungsschleife ist eine direkte Hommage an diese Tradition instruktionsbasierter Spielemusik.
Ein echter qualitativer Sprung?
Willison wirft die Frage auf, ob das Komponieren hier ein ähnliches Phänomen ist wie die jüngsten Sprünge bei 3D-Grafiken: Fähigkeiten, die Textmodelle erst seit wenigen Monaten überzeugend beherrschen. In seinem Blog lässt sich dieser Trend gut nachverfolgen. Im September 2026 beschrieb er, wie GPT-6 Astra in Codex 17 Minuten und 51 Sekunden lang an einem Blender-Modell eines Fabergé-Eis tüftelte – ausgehend von einem einzigen generierten Bild. Noch im November 2025 waren die Modelle bei einem Test gescheitert, der eine einfache POV-Ray-Szene mit einem Pelikan auf einem Fahrrad verlangte: Die meisten Skripte ließen sich nicht einmal parsen.
Aus den aktuellen Beobachtungen lässt sich jedoch nur eine vorsichtigere These ableiten als »LLMs können jetzt komponieren«:
- Symbolische Komposition durch LLMs ist nicht neu: ChatMusician hat das schon Anfang 2024 demonstriert – wenn auch erst nach gezieltem Fine-Tuning.
- Neu ist das selbstständige Problemlösen ohne Spezialtraining: Ein Allround-Modell entwirft aus dem Stegreif ein funktionierendes Format, baut einen Synthesizer und komponiert stilistisch passende Stücke. Ob frühere Modellgenerationen dazu ebenfalls in der Lage gewesen wären, ist genau die offene Frage, die Willison aufwirft. Dafür brauche es, wie er betont, saubere Vergleichstests mit älteren wie neueren Modellen.
Grenzen des Experiments und Gründe zur Skepsis
Ein Prompt, ein Hörer: Ein Urteil wie »überraschend gut« ist ein subjektiver Eindruck, keine statistische Messung. Es existiert bislang kein öffentlicher Benchmark für symbolische Text-zu-Partitur-Kompositionen. Etablierte Ranglisten wie AA-Music-Instrumental und AA-Music-Vocal v1.1 von Artificial Analysis basieren auf paarweisen Blindvergleichen menschlicher Tester für reine Audiogeneratoren. Für Chat-Modelle, die Partituren für Software-Synthesizer schreiben, sind sie schlicht nicht ausgelegt.
Der Hang zur bloßen Nachahmung: Gefragt nach der Qualität von Monkey Island, lieferte Claude vor allem den passenden Stil: Piraten, Häfen, Calypso und Geisterschiffe. Auch wenn es sich um ein Experiment mit eigenständigen Melodien handelt und keine Originalthemen kopiert wurden, ist dieser Reflex bemerkenswert. Die Musikindustrie kämpft derzeit massiv mit KI-Imitationen: Laut einem Bericht der Financial Times, zitiert von IT Home, forderte Sony Music die Streaming-Plattformen bis Ende September auf, über 260.000 KI-generierte Titel zu löschen, die Stimmen bekannter Künstler imitierten – Ende März waren es noch 135.000 gewesen. Ein Computerspiel-Genre stilistisch zu treffen ist zwar etwas anderes als Deepfake-Gesang, der Ausgangspunkt ist jedoch derselbe: »Klinge wie X«.
Klangliche Grenzen der Synthese: Ein Browser-Synthesizer mit 65 Presets fängt den Charme einer Soundkarte von 1990 ein, hat aber wenig mit orchestralem Arrangement oder moderner Audioproduktion zu tun. Ein direkter Vergleich mit Audio-Modellen wie Suno führt daher in die Irre. Die Stärke des Ansatzes liegt darin, dass die Komposition als Code vorliegt – kompakt, editierbar und transparent –, nicht im fotorealistischen Sound.
Wie sich die Fähigkeiten systematisch testen ließen
Das Experiment, das Willison vorschlägt, ließe sich recht unkompliziert umsetzen: Man füttert den veröffentlichten Scrimshaw-Prompt unverändert an verschiedene Modellgenerationen. Der Editor zählt dabei automatisch die Syntaxfehler in den Takten. Die syntaktisch korrekten Stücke werden anschließend menschlichen Testern im Blindvergleich vorgespielt – ganz nach dem Vorbild der Audio-Benchmarks von Artificial Analysis. Bringen ältere Modelle nur fehlerhafte oder belanglose Notenfolgen hervor, während neuere Modelle schlüssige Themen mit klarer Dramaturgie komponieren, wäre Willisons Hypothese einer emergenten Fähigkeit belegt. Falls nicht, lag die eigentliche Leistung eher im durchdachten Notationsformat als in einem echten musikalischen Entwicklungssprung.
Vorerst bleibt die Jukebox vor allem ein faszinierendes Beispiel dafür, wie sich Komposition als Programmieraufgabe begreifen lässt: Klartext rein, Musik raus – inklusive Debugging-Schleife für falsche Töne.
Quellen
- Originalartikel: Simon Willison, »Tool: Scrimshaw Jukebox«, 6. Oktober 2026
- Scrimshaw Jukebox – Projektseite und Notationsleitfaden
- Willisons freigegebener Claude-Chatverlauf
- Ruibin Yuan et al., »ChatMusician: Understanding and Generating Music Intrinsically with LLM«, arXiv 2402.16153, Februar 2024
- The International House of Mojo, »LucasArts' Secret History #6: The Music of LeChuck's Revenge«
- Simon Willison, Blogbeiträge mit dem Tag »3d« (Blender/GPT-6 Astra-Experiment vom 9. September 2026; POV-Ray-Pelikan-Test vom 9. November 2025)
- Artificial Analysis, »Music Generation Benchmarking Methodology«
- IT Home, »Sony Music fordert Löschung von 260.000 KI-Deepfake-Songs« (unter Berufung auf die Financial Times), 6. Oktober 2026